anthropic-Claude 编辑推荐
Anthropic 招股书里藏了句警告:AI 自己改进自己的那天,可能不远了
Anthropic 在招股补充文件的风险提示中承认,公司可能很快触达自己定义的递归自我改进标准,…

文章目录
Anthropic 这周更新了 S-1/A 招股补充文件。多数人的注意力都在营收和支出这些财务数字上,但文件里一段不起眼的风险提示,信息量其实更大。
文件里说了什么
大意是:公司认为,自家模型可能很快就会达到他们自己定义的“递归自我改进”标准。
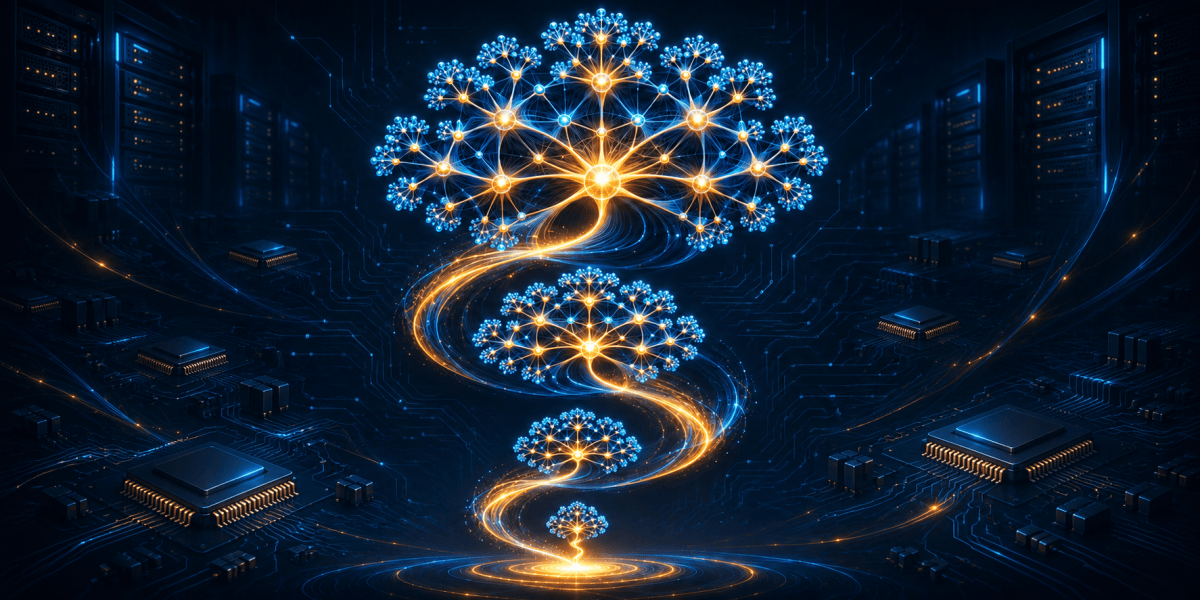
这个词听起来玄,其实不难理解。所谓递归自我改进,就是 AI 能自己训练出更强的下一代,而这个更强的版本又继续改进下下代,能力像滚雪球一样往上走。悲观的人认为,这意味着 AI 迟早强到脱离人类掌控;乐观的人则认为,这是生产力爆发和科学发现的起点。
Anthropic 给的两条提示
第一,公司已经在用 AI 帮忙做研发,部分模型能力出现了明显跃升,但团队当时并没有第一时间察觉。第二,按内部测算和对下一代模型的预期,他们可能很快就会触及《负责任扩缩策略》里那条“由 AI 带来的爆发式技术进展”的红线。
换句话说,Anthropic 担心的是研发速度跑到了配套的安全和对齐工作前面:模型进步太快,验证和防护还没来得及跟上。
也留了余地
文件同时说明,目前所有在售模型都还没越线,并且承诺在可预见的未来,研发流程会保留人类参与,不会在缺少有效人工监督、无法充分理解过程的前提下继续推进。
当然也有人怀疑:招股书既要披露信息,也带宣传色彩,说“快要做出能自我迭代的超强模型”可能只是话术。但不可否认,Claude 今年在编程、数学和网络安全上的提升是实打实的。如果一家以谨慎著称的实验室都说近在眼前,监管规则或许该提前准备起来。
核心看点:
- Anthropic 在招股文件风险提示中承认,可能很快触及自定的 RSI 标准
- 公司已用 AI 参与研发,部分能力跃升当时未被察觉
- 现有模型尚未越线,承诺保留人类监督
本文地址:https://www.163264.com/18987