连续写代码 2 小时 40 分,Fable 5.5 用 66 秒动画把「AI 做视频」换了一条路
一段 66 秒的动画短片,没有用到任何外部图片、素材库、音频采样或字体文件,却包含狐狸、纸鸟、云…

文章目录
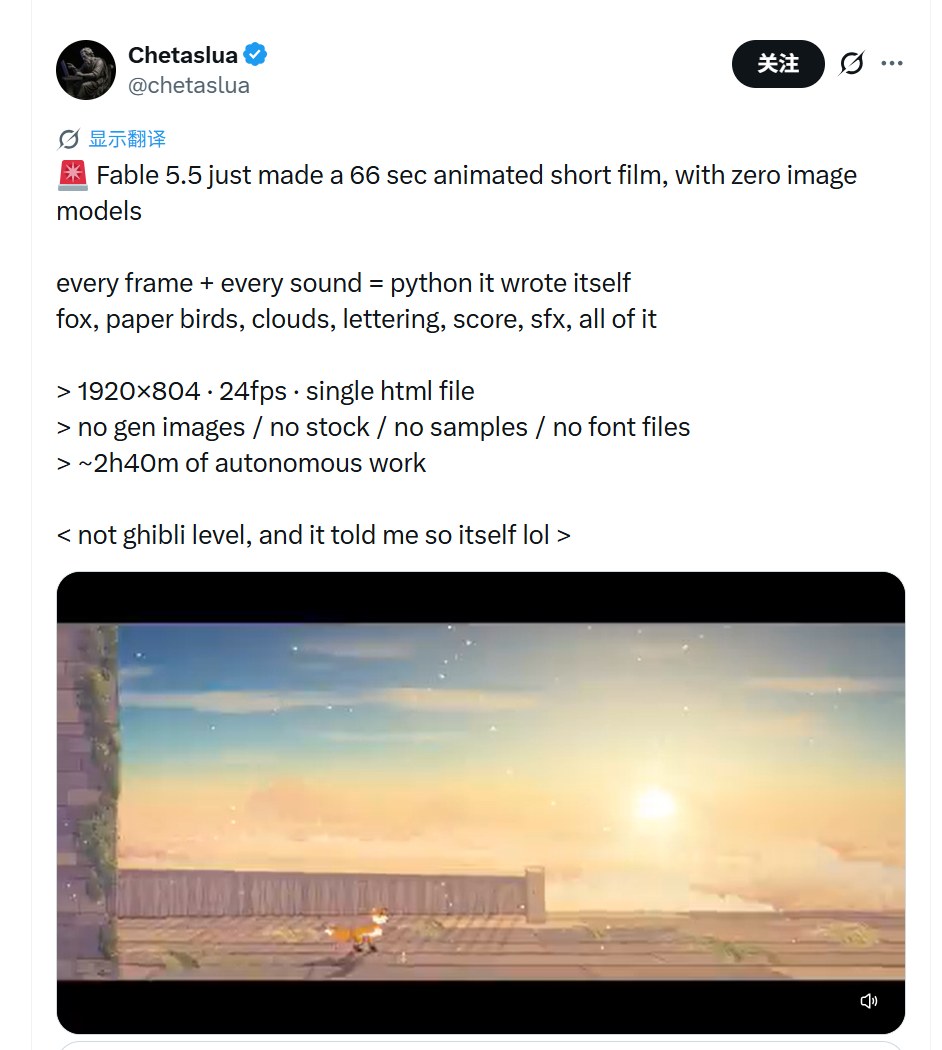
一段 66 秒的动画短片,没有用到任何外部图片、素材库、音频采样或字体文件,却包含狐狸、纸鸟、云层、文字和光影变化,配乐与音效也一并做了出来。完成它的不是视频生成模型,而是一个连续写了两个多小时代码的编程智能体。
11 月 2 日,开发者 Chetaslua 在社交平台发布了这段作品,并称其由 Anthropic 尚未正式发布的 Claude Fable 5.5 独立完成。短片分辨率 1920×804、帧率 24fps,最终被封装成一个 HTML 文件。这个细节很关键:它走的不是「像素生成」路线,而是让模型写程序,再由程序渲染出画面和声音。
一分钟速览
- 测试者称 Fable 5.5 连续自主编写并运行代码约 2 小时 40 分钟,产出 66 秒动画。
- 画面、配乐、音效均由模型编写的 Python 代码生成,未调用图像或视频生成工具。
- 多名开发者还展示了据称由它编写的 Three.js 交互式 3D 场景,包括古帆船、海浪和跑车。
- Anthropic 尚未确认模型的发布时间、性能指标与开放范围,测试也缺少统一评测环境。
它做的不是视频,而是「会画画的程序」
Sora、Runway 一类工具的思路,是让模型直接预测像素,生成结果像一段拍好的素材,优点是直观,缺点是修改困难:想换一个机位、改一句台词,往往要重新生成整段。Fable 5.5 这次展示的路线相反,模型交付的是一套可运行的代码,画面由代码逐帧计算出来。
这带来两个直接差别。第一是可编辑性,动画里的角色、镜头、光效都以参数和函数存在,改一个变量就能重跑;第二是可复现性,同一份代码在不同机器上应当得到一致结果,而不是每次生成都换一个版本。对做分镜预演、数据可视化、教学演示的人来说,这两种特性比「像不像真实拍摄」更重要。
代价也很明显。代码路线要求模型理解几何、光照、时间轴和音频合成,任何一环写错,最终画面就会崩掉;它也不擅长处理真实世界的复杂纹理和人物表演。所以这次演示更像是证明「编程智能体可以独立完成一件完整的作品」,而不是宣布视频生成模型要被取代。
2 小时 40 分钟,考的是长程任务能力
真正值得注意的并不是 66 秒成片,而是中间那 2 小时 40 分钟。模型需要自己拆解任务、安排场景、写渲染逻辑、运行代码、看报错、回头修改,还要在没有人类逐步指导的情况下保持目标不漂移。这与「给一段提示词,几秒钟出图」完全是两种能力。
开发者 Jazil 等人做的对比测试也指向同一点:在自行车、动物角色和人物战斗场景中,Fable 5.5 能在约一小时内完成复杂动态场景的代码编写与运行,而部分现有 Claude 模型会出现代码不完整、动画跑不起来的问题。不过这些测试没有统一环境,提示词、机器配置和评判标准都不一样,不能直接当作模型排名。
从产品角度看,长程自主执行正是编程智能体最值钱、也最难做稳的部分。一次任务跑几个小时,意味着模型要管理上下文、保存中间结果、识别失败原因,甚至学会「先做一个能跑的版本,再逐步加细节」。这套能力一旦成熟,受影响的不会只是动画,还包括数据管道、测试修复、前端页面和自动化脚本。
泄露线索、假权重与 IPO 压力
Fable 5.5 的出现并非毫无预兆。10 月中旬,第三方模型工具 LiteLLM 的 Azure 目录里曾短暂出现名为 claude-fable-5-5 的条目,随后被移除;近日又有开发者发现,Anthropic 官网部分页面的 HTML 源码中出现过 Claude Mythos 5.5 字样。按照现有产品体系,Fable 与 Mythos 使用相同底层模型,但安全限制级别不同:Mythos 面向经过审核的网络安全和生命科学研究机构,Fable 则通过更严格的安全防护向普通用户和开发者开放。
伴随曝光,Hugging Face 上还出现了一个声称包含 Mythos 权重的仓库,参数规模据称达到 14 万亿。但研究人员检查后发现,部分权重存在明显的人工合成迹象,所谓「模型泄露」并没有可靠证据。这类仓库在每次旗舰模型发布前都会冒出来,围观价值大于技术价值。
这轮曝光的时间点也很微妙。Anthropic 11 月 2 日披露的招股文件显示,公司今年前三季度营收达到 332.42 亿美元,但持续增长的算力投入和巨额亏损,让外界更关注下一代模型能否带来实际的技术突破与商业回报。一个能连续工作数小时的编程智能体,恰好是「把算力变成生产力」最容易被讲清楚的故事。
趋势洞察
从代码补全到长时自主执行,AI 编程工具的竞争正在换挡。过去比的是「补全一行代码准不准」,现在比的是「能不能独立交付一个完整产物」,评价周期从秒级拉长到小时级。这会带来三个变化:评测基准需要更接近真实项目,而不是几道算法题;产品需要更强的过程可见性,让用户知道模型卡在哪一步;安全边界也要重新设计,因为一个能连续运行几小时的智能体,出错的影响远大于一次补全。
至于 Fable 5.5 能否把这些演示变成稳定能力,还要等 Anthropic 正式发布和独立评测。至少现在,它提供了一个值得关注的样本:AI 生成内容不一定非要「生成像素」,也可以生成一套能产生像素的规则。
本文地址:https://www.163264.com/19175