2100 万条序列-结构配对:中科大开源 RNA 基础模型,登上 Nature
RNA 药物的管线在变多,mRNA 疫苗已经进了常规医疗,但一个基础问题仍然棘手:给定一段 RN…

文章目录
RNA 药物的管线在变多,mRNA 疫苗已经进了常规医疗,但一个基础问题仍然棘手:给定一段 RNA 序列,能不能准确预测它会折叠成什么结构、承担什么功能。11 月 5 日,中国科大团队给出了一个新答案——开源 RNA 序列基础模型 structRFM,相关成果发表在《自然》。
一分钟速览
- structRFM 由中科大 MIRACLE 实验室周少华教授、熊鹏特任研究员团队研发,成果于 11 月 5 日凌晨发表于 Nature。
- 团队构建了约 2100 万条经计算注释的序列—二级结构配对数据,同时预训练序列上下文与结构依赖。
- 模型仅需输入序列,即可提取序列级、核苷酸级和核苷酸对级特征,用于多种结构与功能推断任务。
- 完整配对数据、模型权重与源代码已开放,论文 DOI 与 GitHub 仓库同步公开。
为什么 RNA 比 DNA 难
DNA 是双链,结构相对稳定;RNA 是单链,会自己和自己配对,折叠出复杂的二级、三级结构。同一个序列,在不同条件下可能形成不同构象,而构象直接决定它能和谁结合、能催化什么反应。理解序列、结构与功能之间的关系,是 RNA 生物学的基础,也是药物设计的前提。
过去几年,借鉴自然语言处理的预训练方法,RNA 基础模型开始出现。但它们大多只学序列,不学结构。问题在于,序列里并不直接写着结构信息——两个相距很远的碱基可能配对,这种长程依赖很难从纯序列统计中学到。
把「结构」提前塞进预训练
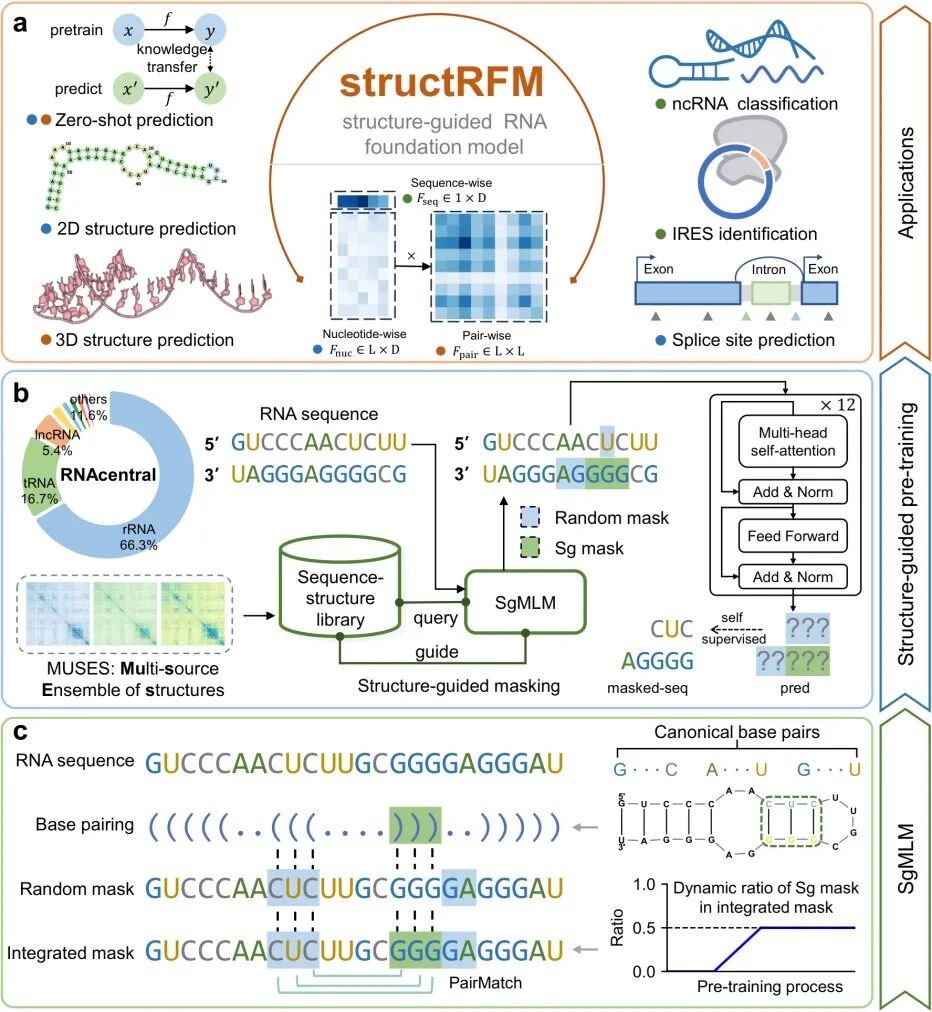
structRFM 的思路是:在预训练阶段就把结构知识注入。团队先构建了约 2100 万条经计算注释的序列—二级结构配对数据,然后设计算法,同时学习序列上下文与结构依赖。
这样做的结果是,预训练后的模型只需要输入序列,就能提取三个层次的特征:序列级、核苷酸级、核苷酸对级。这三个层次对应不同的下游任务——序列级用于分类,核苷酸级用于位点预测,核苷酸对级用于结构预测。
在实验中,structRFM 在零样本同源性分类中表现良好,提高了二级结构预测性能;把它提取的特征融入三级结构预测模型后,三维结构及其对应二级结构的预测结果也有改善。功能推断方面,模型支持剪接位点预测、内部核糖体进入位点识别和非编码 RNA 分类。
泛化能力是另一个观察点。模型在新发布的 RNA 家族上保持了较好的二级结构预测表现,并通过分段策略扩展到长非编码 RNA 分类。消融实验进一步验证了结构信息的引入与掩码策略对性能的贡献。
开源的分量
这项工作值得注意的地方,不只是性能,还有开放程度。团队已开放完整配对数据、模型权重和源代码。对 RNA 领域来说,数据往往比模型更稀缺——高质量的序列—结构配对数据需要大量实验和计算注释,单个实验室很难独立构建。
把数据一起放出来,意味着其他团队可以直接在自己的任务上微调,而不必从零开始标注。这会显著降低 RNA 基础模型的研究门槛,也会加快方法之间的可比性。
从机构层面看,这是中国科大 2026 年以第一署名及通讯单位在 Nature、Science、Cell 三大期刊上发表的第 16 项成果。对一个以物理、化学、生物见长的学校来说,这个数字反映的是交叉学科投入的积累。
趋势:科学基础模型从「更大」转向「更有结构」
蛋白质领域已经证明了结构感知预训练的价值,RNA 正在走同一条路。接下来的竞争点大概有三个:一是数据质量,注释的准确性比数量更重要;二是多模态融合,把序列、结构、表达量、相互作用放在一个模型里;三是可解释性,让预测结果能对应到具体的生物学机制。
对药物研发来说,这类模型的价值最终要落到「能不能筛出可成药的分子」。结构预测只是中间步骤,真正的考验是与湿实验的闭环。开源数据与权重,至少让这个闭环的起点变得更低。
本文地址:https://www.163264.com/19305