十次生成才出一个镜头:AI 视频最贵的不是模型调用费
AI 视频生成速度快了,但创作者的时间被“抽卡”吃掉了。行业经验显示,一部 AI 短漫剧平均要生…

文章目录
一条十秒的 AI 视频,生成可能只要几分钟。但要让画面真正符合分镜要求,创作者往往要反复生成、筛选、再修改——这个被从业者称为“抽卡”的过程,正在成为 AI 内容生产中最隐蔽、也最容易被低估的成本。
一分钟速览
- 行业经验:一部 AI 短漫剧从分镜到成片,平均约十次生成才能得到一次满意结果。
- 单次生成便宜,不等于成品便宜。可用率只有三成时,一个镜头的真实生成成本是标价的三倍以上。
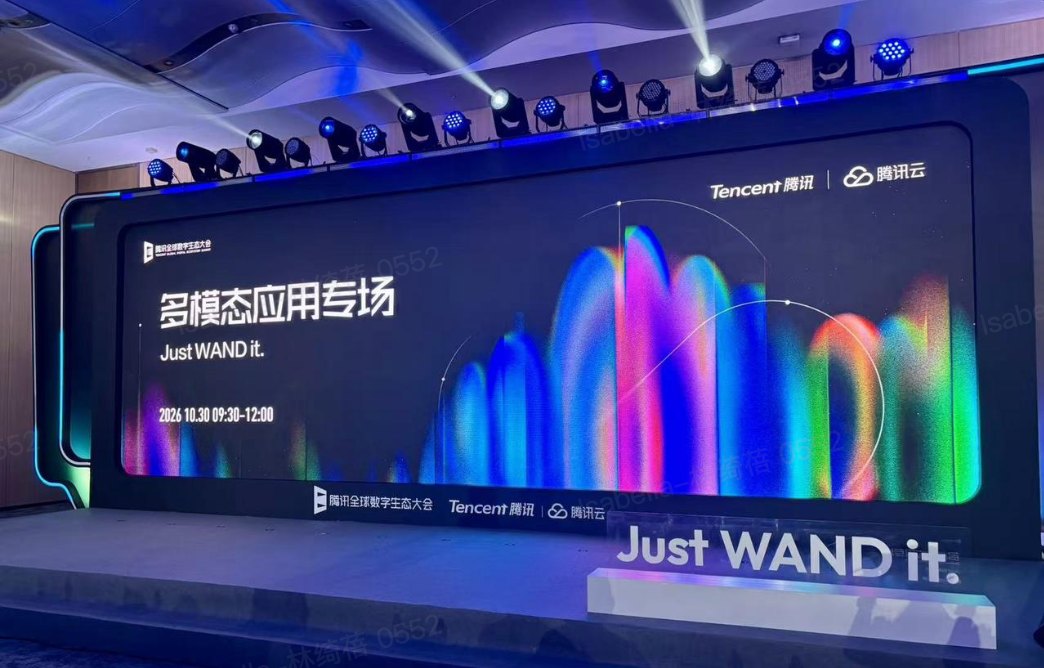
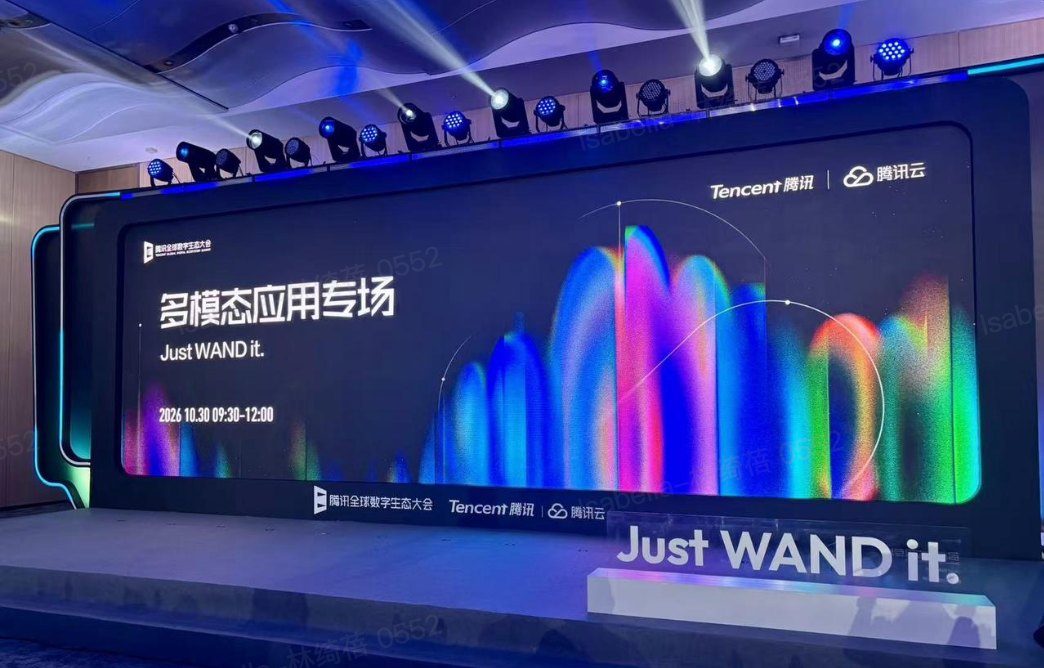
- 腾讯云 WAND 披露的客户案例中,镜头可用率从 30% 提升到 50%—80%,精品 AI 短剧单部成本再降约 30%。
- 竞争焦点正从“生成质量”转向“可用率、可编辑性与交付成本”。
“抽卡”为什么会吃掉利润
腾讯云 WAND 多模态应用负责人朱琳给出的行业经验是:制作一部 AI 短漫剧,从分镜到成片,过程中大约需要十次生成尝试,才能得到一次满意效果。这个数字背后,是模型调用费、等待时间、人工筛选和后期返工的叠加。
成本账其实很好算。假设生成一次视频需要 10 元,平均十次才得到一个可用镜头,仅生成费用就是 100 元;如果可用率提高到 50%,平均两次就能得到可用结果,费用降到 20 元。这还没有算上人工筛选、修改和后期处理的工时。对批量生产内容的团队来说,提高可用率与降低单次调用价格同样重要,甚至更重要。
漫森文化的实践提供了一个更具体的参照。公司助理总经理谭琳介绍,团队此前的镜头可用率约为 30%;接入腾讯云 WAND 的视频生成、画面修复与增强能力后,可用率提升到 50%—80%,经过精细化运营可以稳定在 80% 左右。公司制作的精品 AI 短剧单部成本约为 10 万—20 万元,使用相关能力后成本进一步节约约 30%,整体效率提升约 30%。
电商场景的逻辑类似。紫讯科技联合创始人杜玉生介绍,公司主要服务跨境电商 B 端客户,帮助商家制作广告获客素材。接入 WAND-Vega 后,图片素材的有效使用率从此前的 50%—60% 提升到 70%—80%,在达到相同业务效果的情况下,商家的素材成本有所下降。
问题不只在模型:缺的是“中间层”
今年 9 月发表的论文《Better Call CineCrew: Consistent Ultra-Long Narrative-to-Film Generation》指出,长篇叙事视频生成仍然面临镜头级控制、跨片段视觉身份和角色行为一致性等挑战。研究者认为,现有基于提示词的工作流容易出问题,一个重要原因是剧本与视频生成模型之间缺少结构化的中间层,无法充分表达镜头、角色和连续性等约束。
换句话说,剧本描述了故事要发生什么,却未必明确规定摄像机如何运动、人物站在哪里、哪些细节必须跨镜头保持一致。这些信息如果没有在生成之前被表达清楚,创作者就只能等结果出来之后再反复修改。
腾讯云副总裁、媒体 AI 产品负责人李志成也提到,即使是行业头部的视频生成模型,在光影、物理规律较为复杂的影视场景中,仍有尚未解决的问题。商业生产对多模态模型的要求,已经不只是“画面逼真”,还包括准确遵守指令、保持内容一致、稳定产出符合要求的素材。
减少返工的三条路
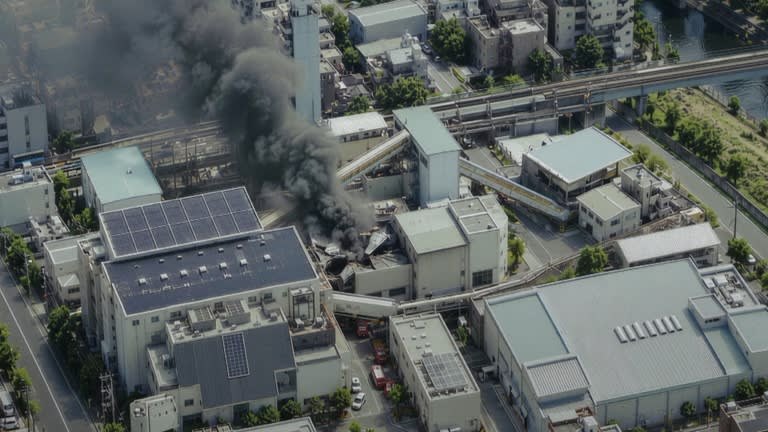
第一条是生成前加约束。WAND 尝试引入 3D 白模:先用 3D 软件生成简化场景视频,确定物体位置、空间关系和部分运动信息,再把它作为参考交给视频生成模型。相比纯自然语言描述,白模把场景布局和运动关系变成了更明确的视觉约束,创作者可以在正式生成前调整空间结构和镜头安排。现场分享的一个案例是,保险客户希望呈现春节燃放鞭炮发生事故、救护车赶到现场的情节,平台先生成白模场景,再交给视频模型生成,从而减少了反复尝试。
第二条是针对专业场景做后训练。WAND-Vega 并不是从零训练的通用基座,而是基于腾讯混元及部分开源基础模型进行后训练和调优。通用场景下现有模型已能满足基本要求,但电商要准确保留商品形状、颜色和标识,影视更关注人物一致性、动作与镜头衔接——这些高频问题需要专门的优化。WAND-Vega 还提供偏性价比的 Lite 和偏生成质量的 Pro 版本;李志成透露,在效果基本对齐部分行业主流模型的情况下,面向成本敏感客户的方案可降低约 20%—30% 的模型成本。
第三条是局部修复代替整体重生成。如果主体内容已经符合要求,只是字幕错误或局部画面瑕疵,重新生成不仅增加成本,还可能破坏原本满意的部分。WAND-EraseVibe+ 采用基于隐空间 Transformer 的生成式修复架构,先把视频编码为隐空间特征,在特征层推断并重建需要修复的区域,再解码回画面。
Agent 接管流程,但判断仍要留给人
一段视频从生成到成片,要经过画面修复、增强、配音、字幕和剪辑等多个环节,涉及不同模型与工具。固定工作流能完成部分任务,漫森文化就通过自研制作中台按预设流程调用;而需要临时组合能力的任务,则更适合交给 Agent。
有平台负责人介绍,其 Creative OS 允许用户用自然语言提出创作需求,由 Agent 参与模型选择和工具调用。平台统计显示,82% 的视频模型调用已经由 Agent 发起,部分过去需要手动搭建画布节点的操作,如今可以交给系统完成。
但自动化不等于可以交付。智象元一沈伟峰指出,普通个人创作者更关注最终结果,专业影视团队还要求创作过程具有较高的可控性和可编辑性:可能认可一个镜头的整体效果,却只想改人物表情;也可能想保留现有场景,只调整镜头运动。如果工具每次都要重新生成完整画面,或者无法保留和编辑中间结果,那么自动化程度再高,也未必适合严肃的商业生产。
下一步:从“能生成”到“能交付”
过去两年,视频模型的竞争主要围绕画质、时长和物理一致性展开;当这些指标逐渐接近可用水平,真正的分水岭变成了单位成品的成本。白模前置、垂直场景调优、局部修复和 Agent 编排,指向的是同一个目标:把不确定的“抽卡”变成可预测的生产流程。
这也意味着,评估一个视频模型不能只看单次生成价格,而要看“得到一个可用镜头”的综合成本;不能只看演示片,而要看批量生产中的一致性、可编辑性和返工率。对内容团队来说,下一阶段的效率提升,可能不再来自换一个更强的模型,而是来自把生成前、生成中、生成后的环节重新组织起来。
本文地址:https://www.163264.com/20004