华为麒麟 9050 把 30B MoE 塞进手机:端侧 AI 跨过一道分水岭
华为首次完整披露麒麟 9050 的新一代达芬奇 NPU:性能提升 140%、功耗降低 66%,业…

文章目录
华为麒麟官方公众号今天发布技术详解,第一次把麒麟 9050 系列芯片里的新一代达芬奇架构 NPU 讲清楚:性能提升 140%,功耗降低 66%,并且是业界第一个把 30B MoE 大模型放进端侧运行的方案。官方对体验的描述很朴素——不用联网,不用等云端。
一分钟速览
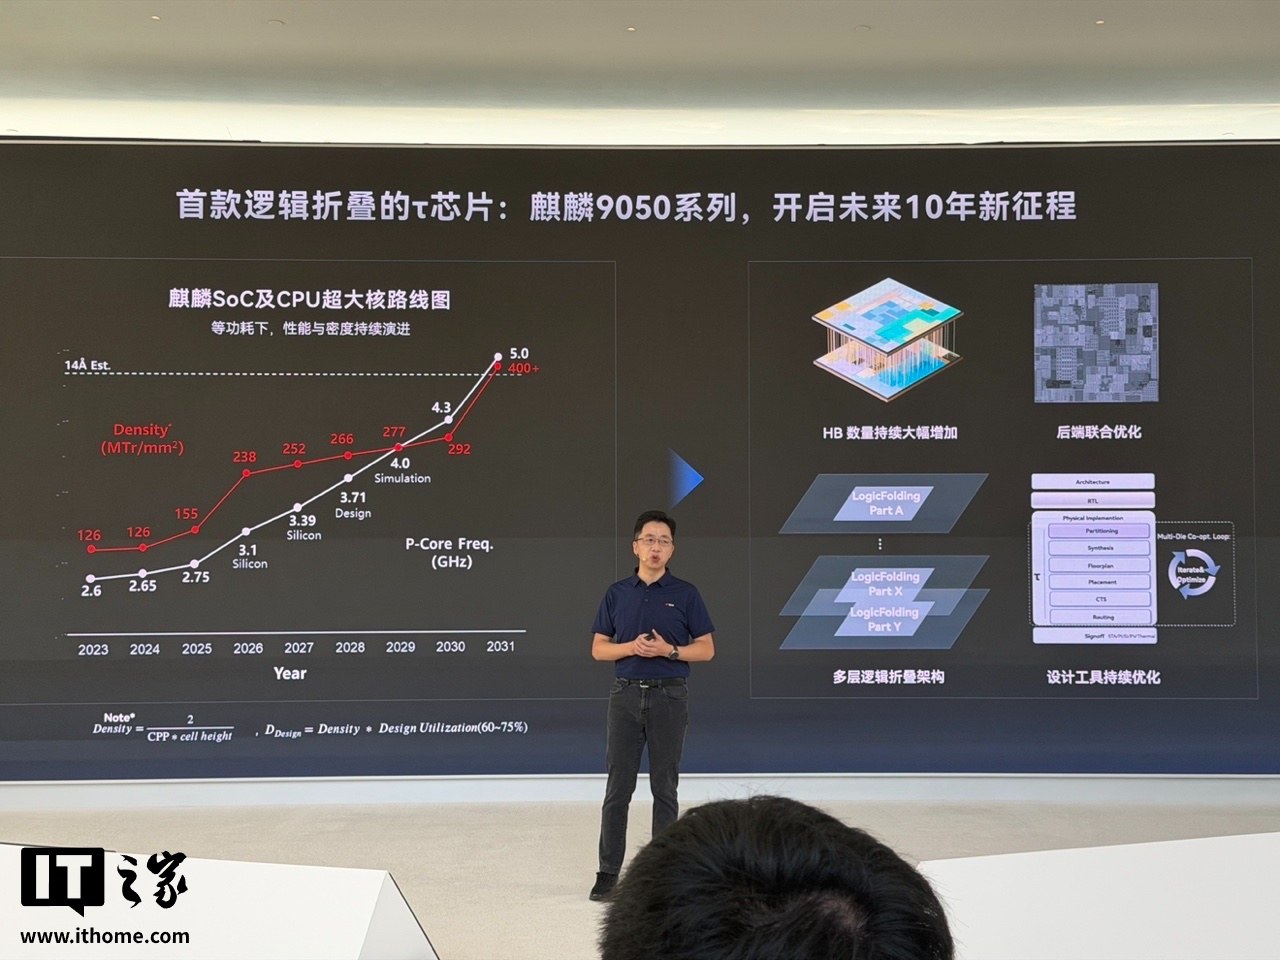
- 麒麟 9050 系列是首款采用「逻辑折叠」技术的 τ 芯片,新一代达芬奇 NPU 同步亮相;
- NPU 性能提升 140%、功耗降低 66%,支持 Transformer 引擎、超低功耗感知引擎和 CANN 异构计算架构;
- 业界首个 30B MoE 大模型入端,靠多级存算协同优化与低比特量化压住内存和算力开销;
- 能力落到四个感知场景:AI 屏幕朗读、Xmage 智拍 2.0、AI 眼动翻页、熄屏地图 2.0;
- 华为在 10 月的麒麟媒体沟通会上称,9050 系列将开启未来十年,目标是 2031 年 P 核频率突破 5GHz。
把 30B 放进手机,难的不是“塞得下”
一个大模型要在手机上跑起来,首先要过内存这一关。30B 参数即使按 4 bit 量化,权重也有十几 GB,再加上 KV 缓存和运行时开销,很容易把手机的可用内存吃穿。华为给出的解法是两句话:多级存算协同优化,以及低比特量化。前者是把权重按访问频率分层放在片上缓存、内存和闪存之间,让真正频繁参与计算的部分留在离计算单元最近的地方;后者是把精度压到足够低,同时用训练侧的手段把精度损失补回来。
MoE 架构在这里是关键。它让每次推理只激活一部分专家,而不是把全部参数都算一遍,等于用“稀疏激活”换“更大参数量”。这对端侧尤其友好:模型总容量可以做得很大,但单次推理的算力和功耗只跟激活部分相关。真正的难点在于调度——专家怎么分布、路由怎么做、缓存命中率怎么保证,这些工程细节决定了用户拿到的是“能用”还是“好用”。
140% 和 66% 是怎么来的
性能提升 140%、功耗降低 66%,这两个数字放在一起,说明这一代 NPU 不是简单堆算力,而是改了计算的组织方式。Transformer 引擎负责把注意力机制里最耗时的矩阵运算做成硬件流水线;超低功耗感知引擎负责让屏幕、影像、人眼、位置这些常开能力在不唤醒主处理器的情况下完成;CANN 异构计算架构则把 CPU、GPU、NPU 的任务编排统一起来,避免数据在多个单元之间反复搬运。
对手机这种散热和电池都受限的设备来说,能效比往往比峰值算力更重要。一个模型如果在实验室里跑得飞快,但十分钟就把手机烫到降频,用户体验仍然是失败的。华为把功耗降幅单独拿出来讲,说明这一代产品的目标不是跑分,而是让端侧大模型可以长时间、低负担地待在后台。
四个场景,比参数更能说明问题
官方列出的落地功能包括:感知屏幕的 AI 屏幕朗读,可以理解当前页面内容并用语音讲出来;感知影像的 Xmage 智拍 2.0,把拍摄意图理解放进取景和成片流程;感知人眼的 AI 眼动翻页,用视线控制阅读;感知位置的熄屏地图 2.0,在锁屏状态下提供轻量导航信息。
这些功能的共同点是“低延迟、常在线、不打扰”。它们不需要用户打开某个 App,也不需要把数据传到云端再等结果。端侧模型的价值恰恰在这里:隐私留在本地,响应时间压到毫秒级,网络不好时也不影响使用。相比之下,把请求发到云端再返回,哪怕只多几百毫秒,也会让交互显得迟钝。
端侧 AI 的竞争,换了一条赛道
过去两年,端侧 AI 的叙事主要是“把模型缩小”:7B、3B、1B,参数越少越容易落地。麒麟 9050 走的是另一条路——用 MoE 和存算协同,把更大的模型搬上手机。这两种路线并不矛盾,但指向不同的产品形态:小模型适合做单点功能,大模型才能承担理解上下文、连续对话、跨应用操作的 Agent 角色。
当然,30B 入端不意味着手机能替代云端。复杂推理、长文档处理、多模态生成仍然要交给数据中心。但在“日常理解”这一层,端侧模型正在变得足够好。当模型不用联网、不用排队、不用担心隐私,很多原本只在云端成立的功能,会开始往设备上迁移。麒麟 9050 的意义,或许不在于它今天能跑什么,而在于它把端侧 AI 的天花板又往上抬了一截。
本文地址:https://www.163264.com/20461