不用显卡也能跑 2.8 万亿参数:玩家用停产傲腾内存跑通 Kimi K3,每秒 1.5 个词元
跑大模型一定要堆显卡吗?一位 Reddit 网友给出的答案有点反常识:不用显卡,用已经停产的英特…

文章目录
跑大模型一定要堆显卡吗?一位 Reddit 网友给出的答案有点反常识:不用显卡,用已经停产的英特尔傲腾持久内存,也能把 2.8 万亿参数的 Kimi K3 跑起来——虽然速度慢到每秒 1.5 个词元,但确实跑通了。
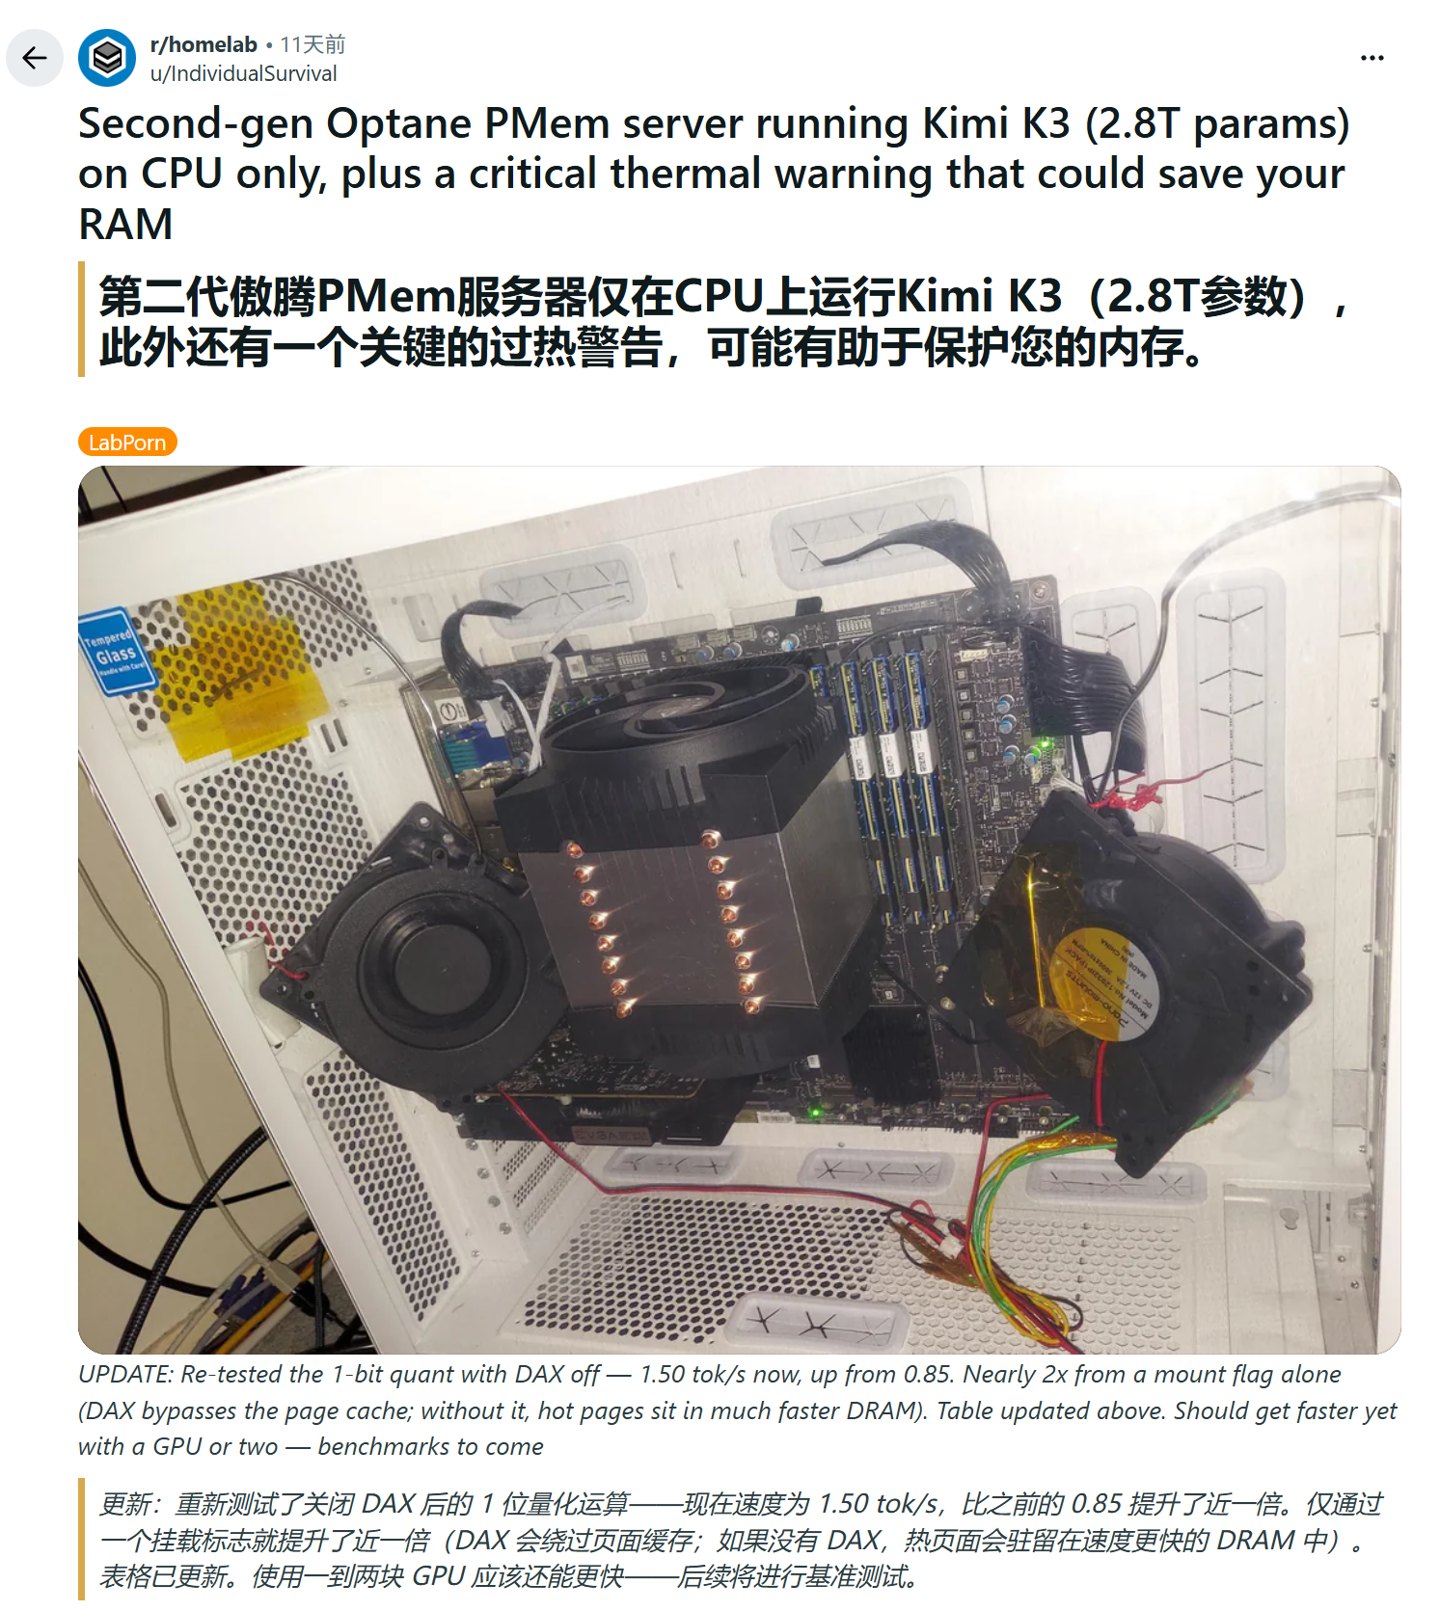
这位网名为 u/IndividualSurvival 的玩家在 11 月 2 日发帖,分享了自己的家庭实验室尝试。整套配置没有独立显卡,核心是一颗 40 核的第三代英特尔至强可扩展处理器,加上傲腾持久内存 200 系列,软件侧使用 llama.cpp 执行推理。
一分钟速览
- 模型规模:月之暗面 Kimi K3,2.8 万亿参数。
- 硬件路线:40 核至强 + 傲腾持久内存 200 系列,无独立显卡。
- 运行方式:App Direct 模式,DRAM 与傲腾作为两个独立数据空间,llama.cpp 推理。
- 速度:1 比特量化初始约 0.85 词元/秒;关闭 DAX 后提升到 1.50 词元/秒。
- 代价:3 比特量化仅 0.75 词元/秒,生成 5 万个词元约需 18.5 小时。
傲腾是什么,为什么能跑大模型
傲腾(Intel Optane)是一套基于 3D XPoint 技术的内存与存储产品,由英特尔与美光共同开发,属于非易失性存储。它最大的特点是容量大、断电不丢数据,同时读写延迟远低于普通固态硬盘,外形和安装方式接近服务器内存条。傲腾持久内存 200 系列单条提供 128GB、256GB、512GB 三种容量,原本针对第三代至强可扩展处理器平台设计。
大模型推理的瓶颈往往不是算力,而是显存装不下模型。2.8 万亿参数的模型,即使做了极限量化,体积依然远超普通显卡的显存上限。傲腾的大容量正好补上这个缺口:把模型权重放在持久内存里,让 CPU 直接寻址,虽然带宽比不上 HBM,但至少「装得下」。
速度背后的取舍
这套方案的成绩单很诚实:采用 1 比特量化、压缩模型数据后,初始生成速度约每秒 0.85 个词元;关闭直接访问功能 DAX、让常用数据受益于 DRAM 缓存后,速度提升到每秒 1.50 个词元。另一项 3 比特量化测试只达到每秒 0.75 个词元,生成 5 万个词元大约需要 18.5 小时。
作为对比,云端推理服务动辄每秒几十到上百个词元。也就是说,这套家庭实验室方案的速度大约只有云端的几十分之一。它的意义不在「可用」,而在「可行」——证明了在没有 GPU 的情况下,靠大容量持久内存和 CPU 推理,依然能把超大模型跑起来。
为什么这件事值得关注
第一,它揭示了推理成本结构的另一种可能。当模型越来越大,显存成为硬约束,存储层级的选择会变得比纯粹的算力更重要。傲腾虽然已经停产,但它代表的方向——用大容量、低延迟的非易失内存承接模型权重——正在被 CXL 内存池、HBM 堆叠等新技术延续。
第二,它说明开源推理栈的适配能力。llama.cpp 能在这种非常规硬件组合上跑通,靠的是对量化格式、内存映射和 CPU 指令集的长期打磨。这也是为什么每次有新硬件路线出现,开源社区总是最先跑出可用 Demo 的地方。
第三,它对「本地大模型」的想象空间是一次提醒。大多数人认为本地部署的天花板是几十亿到几百亿参数,这套实验把上限推到了万亿级,代价是速度。对于不需要实时交互的场景——比如夜间批处理、离线知识库构建——慢一点未必不能接受。
趋势洞察
当然,这只是一个测试项目,不具备日常可用性。18.5 小时生成 5 万个词元,离产品化还有很远。但它提出的问题很现实:当 GPU 供应紧张、显存价格高企,推理侧会不会出现更多「以容量换速度」的方案?从内存厂商到云服务商,答案正在往「是」的方向走。
对普通用户来说,这条新闻的趣味大于实用;对做基础设施的人来说,它是一个值得记下的信号——大模型的门槛,不一定只由显卡决定。
本文地址:https://www.163264.com/20898