116 个任务、4207 场湿实验:新基准给 AI 科研“判卷”,Opus 5.5 和 GPT-6 Astra 都还差得远
UniPat AI 牵头发布 SPU 基准,用未发表的湿实验结果给模型的科研预判打分:允许联网、…

文章目录
给 AI 一道化学题,它现在能查文献、能调软件、能连续算上几个小时。但如果换一种考法:只给实验条件,让它先猜结果,再拿真实湿实验的数据对答案呢?
这就是 UniPat AI 牵头推出的新基准 Science Prediction Universe(SPU)想回答的问题。它不考刷题,考的是科研里含金量最高的那一步:动手之前,判断什么值得做。
一分钟速览
- SPU 包含 116 个任务、4207 场湿实验,覆盖化学、材料、生物、医学共 32 个子领域。
- 100 个公开任务取自 85 篇近期论文,16 个私有任务来自四组未发表合作实验,实测结果对模型隐藏。
- 每次评测给模型 8 小时、8 核 CPU、16GiB 内存和一块 H20,允许联网检索、安装科研软件。
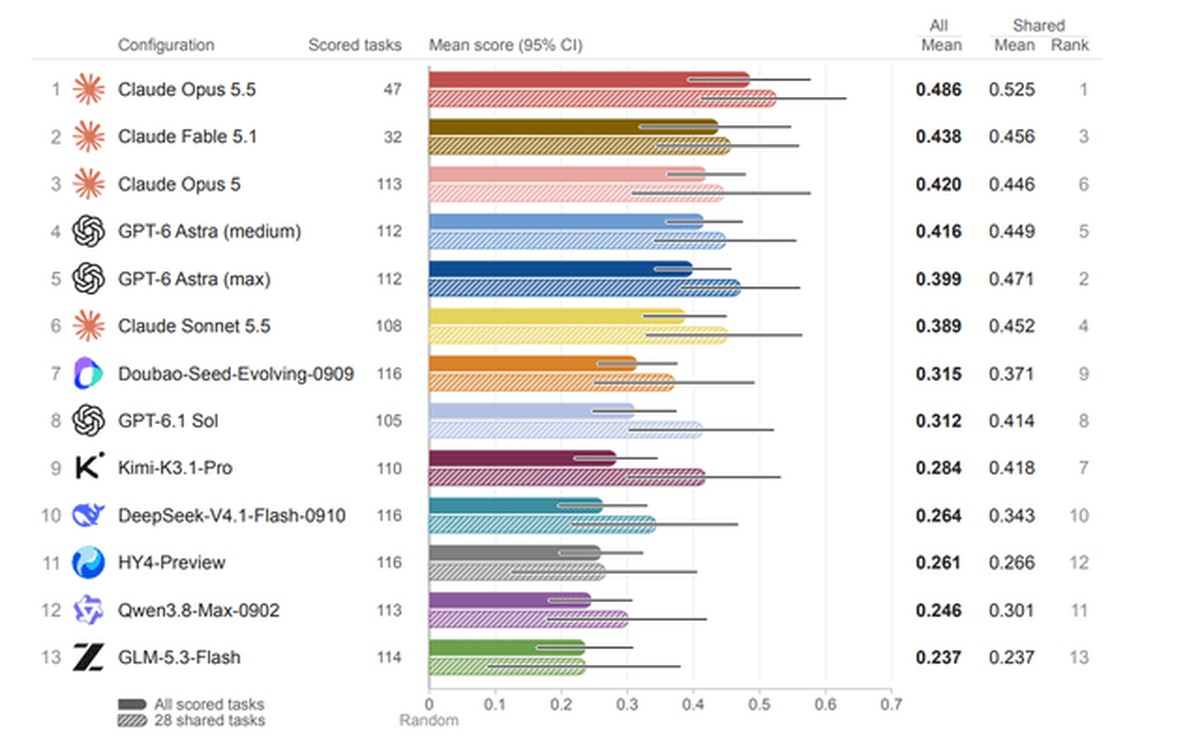
- 评分在断网容器中进行,用 Spearman 相关系数比对预测排序与实测排序;Opus 5.5、GPT-6 Astra 距离可用仍有明显差距。
为什么“预测实验”值得单独出一张试卷
在真实科研里,一次湿实验的成本远不止试剂钱。做化学要配试剂、设反应条件、再分离产物;做生物要等漫长的蛋白表达。方向选错,几周时间就没了。所以科学家真正的“品味”,体现在能不能在动手之前判断哪条路更可能出结果。
AI for Science 走到今天,模型已经能自主查文献、调用软件,甚至连续工作数小时。能力上来了,评价体系却没跟上。BrainBench 让模型直接判断实验结果,ScienceAgentBench 侧重在已有数据上做分析,Terminal-Bench 4.0 这类长程任务基准主要检查任务产物——它们都没有把“自主研究过程”和“湿实验预测准确度”放在同一张卷子上。
出题方式:把简单题全部剔掉
SPU 的题目筛选相当苛刻。专家优先选择测量完整、条件清楚的研究;沿着单一趋势就能排序的简单问题直接剔除,数值过于接近、缺乏区分度的也会被判定参考意义不大。留下来的题,都是需要模型真正理解机制才能排对顺序的。
16 个私有任务尤其关键,它们来自四组尚未发表的合作实验,涉及 VHH 纳米抗体、反应条件、电解液和 Magrolimab 变体。因为答案从未公开,模型不可能“背过”,这在一定程度上阻断了记忆污染。
评测过程:像雇了一位研究员,然后只看结论
模型在 8 小时窗口内自行搜集证据、选择计算方法,最后提交各比较组从低到高的预测排序。为了防止作弊,评分全程在独立断网容器里进行,禁止检索原始研究结果,系统还会自动扫描工具输出,识别源论文的 DOI、标题等标识符。
这套设计的价值在于,它同时考验三种能力:科学工具的使用、长程任务的执行、以及在信息不完整时的判断。任何一环掉链子,最终排序都会失分。
结果:算力翻五倍,也救不了判断力
结论并不好看。即便是 Opus 5.5、GPT-6 Astra 这一档模型,在已评分任务上的平均表现距离“可靠预测”依然遥远;把推理预算拉满、算力翻五倍,提升也相当有限。这说明瓶颈不在算得多快,而在有没有形成可迁移的科学直觉。
对做科研智能体的团队,这是一条很实在的提醒:把模型接到实验室设备上、让它跑通流程,只是工程问题;让它判断“该做哪个实验”,是另一类问题。前者能靠工具链解决,后者需要模型真的理解机制。
趋势洞察:AI 科研的竞争,正在从“能不能做”转向“值不值得做”
过去两年,AI for Science 的叙事主线是自动化:自动读论文、自动写代码、自动跑模拟。SPU 把评价重心挪到了决策质量上,这大概率会成为下一阶段的分水岭——实验室不缺会执行的手,缺的是能少走弯路的判断。
更现实的影响在资源分配。当企业开始用 AI 筛研究方向,衡量标准就不再是“模型能生成多少假设”,而是“按它的建议做,命中率提高了多少”。这类可量化的指标,才会真正进入采购决策。
基准的意义从来不是排名,而是把模糊的能力讨论变成可复现的数值。SPU 给出的这组数值目前偏低,但至少给所有科研模型标出了一条同一起跑线。
本文地址:https://www.163264.com/21180