商汤发布 SenseNova Loop-9B:9B 参数跑出 27B 级表现,10GB 显存就能部署
商汤正式发布 SenseNova Loop-9B,用循环结构复用中间层把 32 层算成 56 层…

文章目录
商汤在 11 月 17 日晚间正式发布了 SenseNova Loop-9B。这款模型的思路有点反常识:不靠堆参数,而是让同一批网络层多跑几遍,用“循环”把计算深度撑上去。
具体做法是把第 4 到第 27 层做成一个共享权重的循环模块,一次前向传播里把这个模块跑两次。于是物理上只有 32 个解码层,实际完成的是 56 次层计算。再加上双流 mHC(流形约束超连接)在两条残差流之间做信息路由和融合,模型在约 9B 参数的总量下,拿到了更接近大模型的推理深度。
最直接的好处是省显存。官方给出的数字是:4bit 量化后权重约 4.9GB,部署显存需求可以压到 10GB 以内。如果跑 256K 长上下文、用 4bit 权重加 8bit KV 缓存,显存占用大约 15GiB。换句话说,一张中端显卡甚至一些低显存芯片,也能跑起来。
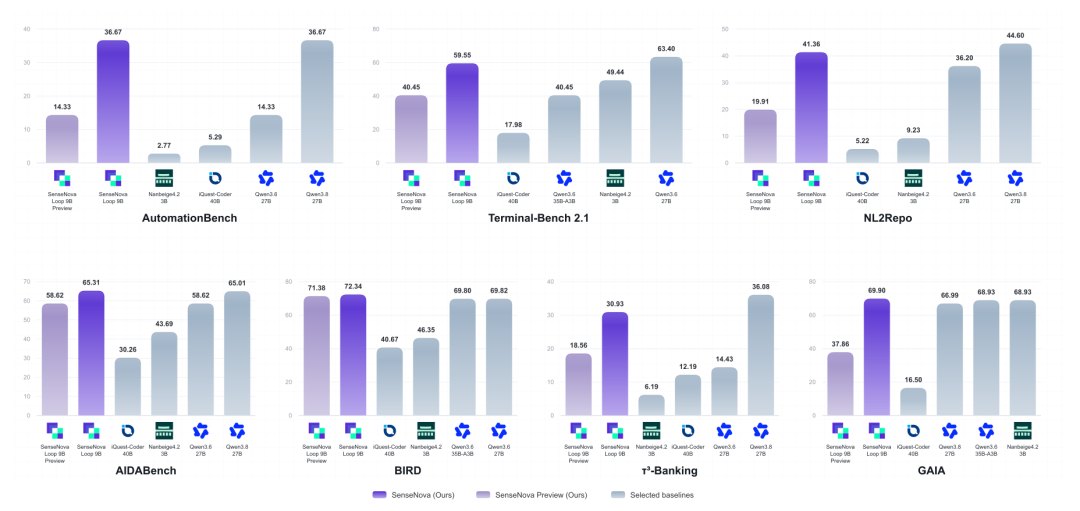
能力上,官方拿它和 Qwen3.8-27B 做了对比。在 NL2Repo 上得分 41.36,接近后者的 44.60;在 AIDABench 上拿到 65.31,略高于后者的 65.01。也就是说,参数只有三分之一左右,Agent 和数据分析类任务的表现基本打平。
模型支持文本和图像输入、文本输出,上下文最长 512K tokens,训练数据覆盖文本、图像、代码和工具调用轨迹。解码器按四层一组,采用三层线性注意力加一层全注意力混合配置,兼顾长文本效率。
对想自己部署的团队来说,还有一个细节值得注意:官方在发布首日就同步提供了 AWQ 4bit 量化版本,不用自己折腾量化流程。模型权重和代码已经开放下载,开发者和研究者可以直接拿去部署、微调或做评测。
本文地址:https://www.163264.com/21621