“AI 写的代码必须开源”吵翻了:Anthropic 招股书自己承认可能触发 GPL
开源开发者 Jakub T. Jankiewicz 主张 AI 生成代码应开源或进入公共领域,A…

文章目录
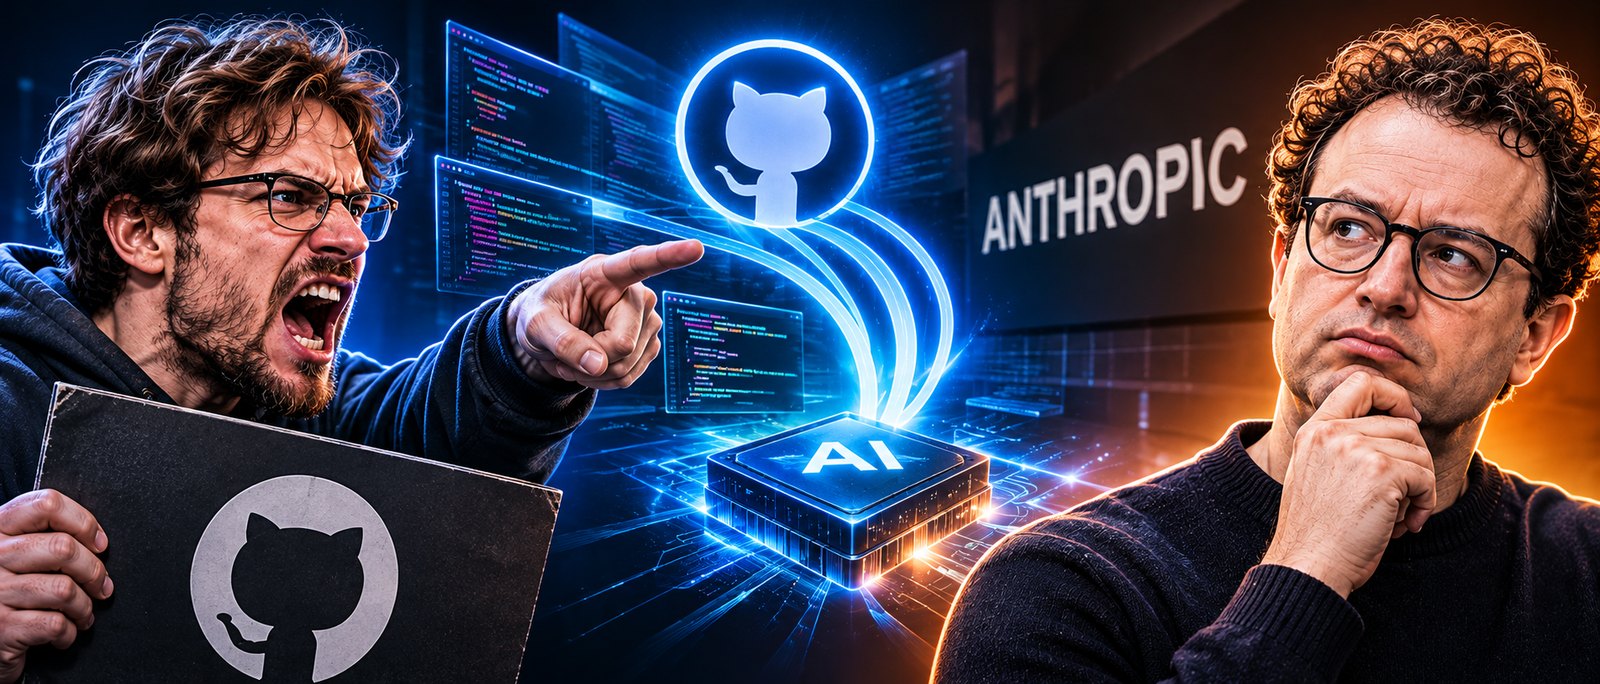
一句“所有 AI 生成的代码都应该开源”,把开发者社区劈成了两半。11 月 15 日,开源开发者 Jakub T. Jankiewicz 公开提出这个主张,理由很直接:AI 模型从开源社区几十年积累的代码和技术知识中受益,企业却可以用这些模型生成闭源软件,把集体成果变成自己的商业资产。
一分钟速览
- 争议核心:AI 训练依赖开源代码,输出却可以闭源
- Jankiewicz 主张 AI 生成代码开源或放入公共领域
- Anthropic 招股书承认生成代码可能触发开源许可证义务
- 其商业条款又向客户转让模型输出相关权利
什么是“许可证洗白”
开源许可证不是摆设。GPL 这类传染性许可证要求衍生作品以同样方式开源,目的是防止有人拿社区代码做闭源产品。Jankiewicz 担心的是,AI 模型把受许可证约束的代码学进参数里,再生成一段“看起来全新”的代码,许可证义务就被绕过去了。他把这称为许可证洗白。
这个质疑并不新鲜,但这次有了更硬的注脚。Anthropic 在招股书中承认,使用 Claude Code 等工具生成的代码可能包含或复现开源软件,从而触发许可证义务,严重时甚至需要公开部分专有源代码。与此同时,它的商业条款又明确向客户转让其拥有的模型输出相关权利。两句话放在一起,矛盾就出来了:一边说输出可能带开源义务,一边把输出权利卖给客户。
开发者为什么吵起来
支持者认为,AI 公司靠开源代码发展壮大,如今应该让生成的代码回馈社区。反对者则反问:自己花几个月设计、调试的软件,难道因为用了 Claude Code,就必须把全部源代码免费公开?这两种立场都有现实基础,冲突点在于“贡献”和“使用”的边界在哪里。
更复杂的是,模型输出很难逐行追溯。一段代码可能同时混有公共领域片段、MIT 许可代码、GPL 代码和模型自己生成的逻辑,开发者很难判断哪部分触发了什么义务。要求每个使用 AI 编程的团队都做许可证审计,成本高得离谱;完全不审计,又等于把风险留到诉讼阶段。
可能的解法
短期看,行业更可能走向“分层处理”:模型厂商提供输出溯源和许可证检测工具,企业在合并 AI 代码时做扫描;对高风险场景,要求模型避免复现受强传染性许可证保护的片段。长期看,则需要法律层面明确,模型输出在多大程度上算衍生作品。
Jankiewicz 的主张更像一个谈判起点,而不是可立即执行的规则。但它提出了一个无法回避的问题:当 AI 的生产能力建立在开源社区之上,商业公司应该承担怎样的回馈义务?这个问题没有技术答案,只有利益分配答案。开发者社区的争吵,才刚刚开始。
本文地址:https://www.163264.com/21663