大模型 编辑推荐
寒武纪 Day 0 适配商汤 Loop-9B:把 56 层循环计算搬上 MLU
商汤 Loop-9B 发布当天,寒武纪就完成了 MLU 适配:静态展开 56 层循环、复用 vL…

文章目录
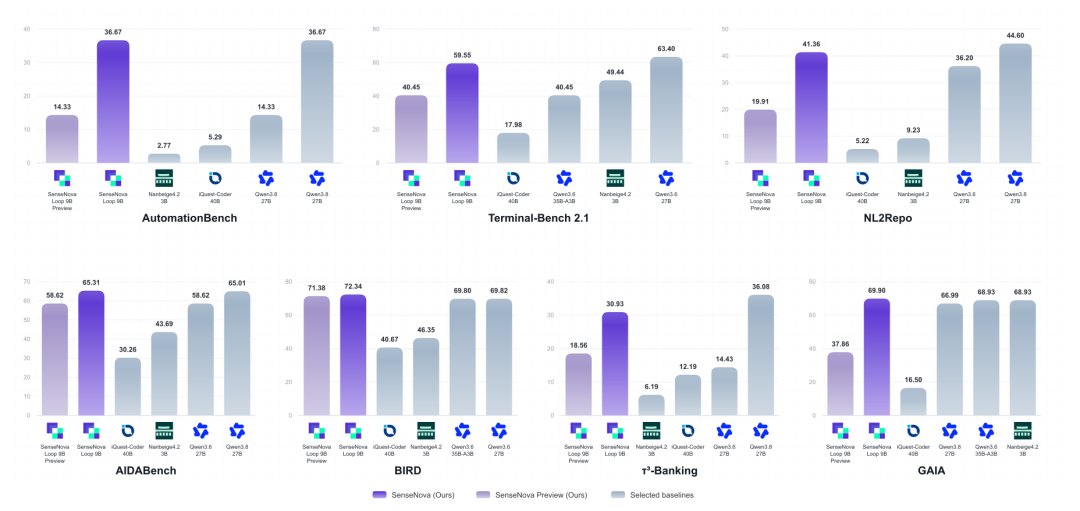
商汤昨晚发布 Loop-9B 之后,寒武纪几乎同一时间宣布完成 Day 0 适配,模型已经能在自家的 MLU 加速卡上跑通推理。
所谓 Day 0,指的是模型发布当天就能用,不用等厂商慢慢调优。对想私有化部署的企业来说,这决定了新模型能不能第一时间进测试环境。
Loop-9B 的结构比较特殊。它只有约 9B 参数,却把 32 个物理层循环执行成 56 次层计算,用重复利用参数的方式把推理深度拉长。好处是 4bit 量化后权重只有约 4.9GB,10GB 显存以内就能部署。
难点在推理框架。vLLM 习惯按顺序调度固定层数,遇到循环结构容易卡住。寒武纪的做法是“静态展开”:把循环计算摊平成 56 个依次执行的层,让模型继续复用 vLLM 的标准调度和 KV cache。不同执行槽位共享同一份权重,显存占用和 32 层模型持平。
算子层面,Attention、线性注意力和 MLP 直接换成 vllm_mlu 里现成的 Qwen3-Next 实现;多模态部分复用 Qwen3.5-VL 的视觉编码器和处理器,图像输入也能走通。
模型里还有一个 mHC 双流路由,涉及归一化和 Sinkhorn 迭代,计算量不小。寒武纪用融合接口把归一化合成一步,又用自动生成工具把 Sinkhorn 压成单个 Triton Kernel,减少反复启动调度带来的开销。
从结果看,国产芯片对新模型的跟进速度已经从“按月”缩到“按天”。模型迭代越快,这种当天适配的能力就越关键。
本文地址:https://www.163264.com/21669