全球首个医疗 AI 独立评测平台上线:29 家机构、22 个模型、1034 项任务
一个在健康问答里表现优秀的模型,能不能看懂疑难病例里的关键线索?能不能在电子病历系统里准确完成操…

文章目录
一个在健康问答里表现优秀的模型,能不能看懂疑难病例里的关键线索?能不能在电子病历系统里准确完成操作?能不能处理医学研究和医疗运营中的多步骤任务?这些问题,单项基准答不了。现在有人试图给出一张统一的考卷。
一分钟速览
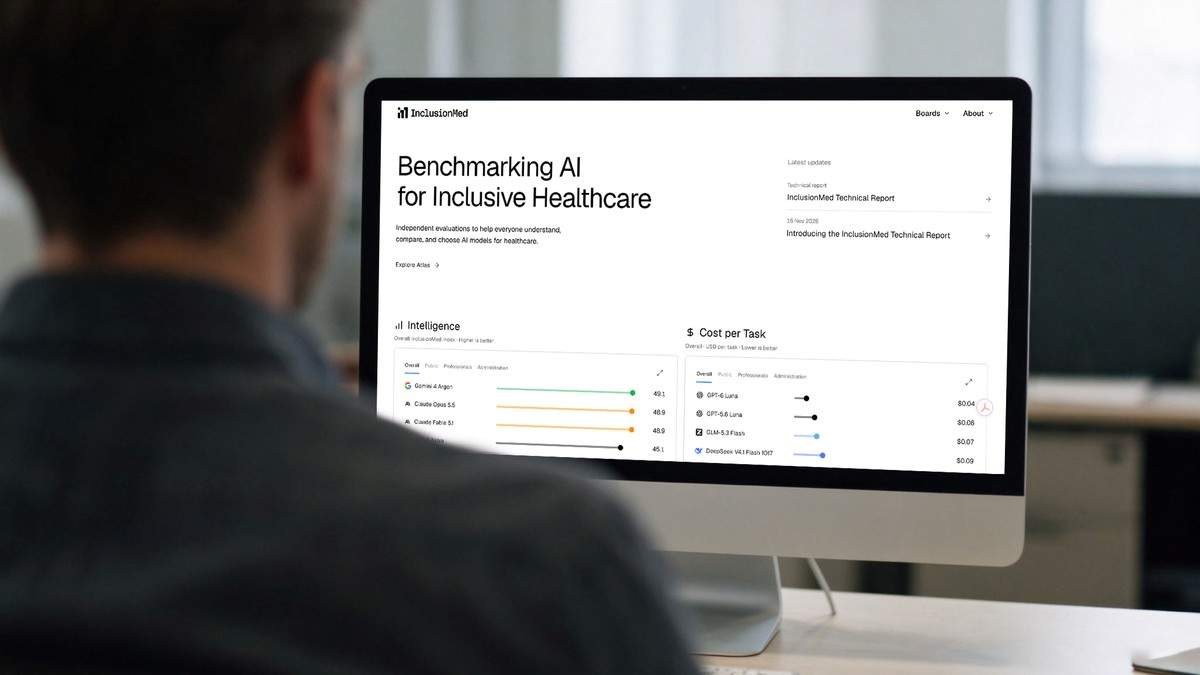
- 全球首个医疗健康 AI 独立评测与分析平台 InclusionMed 正式上线,同步推出评测图谱 Atlas 和首期指数 Index。
- 由斯坦福、哈佛、北京协和医学院、蚂蚁集团、InclusionMed.AI 等 29 家机构的研究人员共建。
- Atlas 用「面向谁」乘「考察什么能力」搭出九宫格:三类角色乘知识、推理、任务执行三类能力。
- 首期聚焦临床诊疗与医疗管理,纳入 5 项基准、1034 项任务,比较国内外 11 家厂商的 22 个模型。
- 除 4 项公开基准外,团队自建 InclusionMed-DxFiles,用顶级医学期刊的疑难病例考察临床判断。
为什么医疗 AI 需要第三方打分
医疗是 AI 落地最谨慎的领域,也是最容易被单一指标误导的领域。一个模型在医学考试题上拿高分,不代表它能在真实病历里找到那条被埋在第三页的异常指标;反过来,一个在单项任务上表现平平的模型,可能在结构化信息提取上非常可靠。行业里不缺基准,缺的是把不同基准放在同一张地图上、说清楚「谁测了什么、谁没测什么」的人。
InclusionMed 的定位正是这张地图。它不生产新的排行榜,而是把已有基准按两个维度归位:面向患者与公众、医疗专业人员、医疗管理人员三类角色,考察知识、推理、任务执行三类能力,交叉成九宫格。每一项基准按主要评测内容填进格子,空白的地方就是行业还没覆盖的需求。
首期考了什么
首期指数聚焦临床诊疗与医疗管理两个方向,纳入五项评测基准、1034 项任务,对国内外 11 家厂商的 22 个模型做系统比较。为了保证结果可信,团队对纳入的基准做了独立复测,并从医疗相关性、评测可信度、场景互补性等角度筛选,最终保留四项公开基准,再与自建的 DxFiles 共同构成首期指数。
DxFiles 是这套体系里最有辨识度的部分:它取材于顶级医学期刊刊载的疑难病例,要求模型结合病例线索做临床判断,而不是回答标准化选择题。这类任务的难点在于信息不完整、干扰项多、正确答案依赖临床经验——恰好是真实诊疗的样子。
评测不是排行榜
值得强调的是,Index 呈现的不是一个总分排名,而是模型在不同任务中的优势与不足。对医院采购方来说,这比「谁第一」有用得多:做病历质控的团队关心结构化抽取,做辅助诊断的团队关心推理链条,做患者服务的团队关心可读性和安全性,它们需要的是不同的证据。
项目组接下来的方向也已明确:与医疗机构和研究团队合作,围绕复杂治疗选择中的医患共同决策、资源约束下的诊疗调度等场景开发新任务。这两个方向都指向同一个现实——医疗 AI 的价值不在「答对一道题」,而在「参与一个流程」。
趋势洞察
医疗 AI 的竞争正在从模型能力转向证据体系。监管要证据、医院要证据、患者也要证据,而证据的前提是有一套各方都认的评测标准。由学术界、产业界和临床机构共建的第三方平台,恰好填补了厂商自测与监管审批之间的空白。当然,评测体系本身也需要被评测:基准会不会被刷分、任务是否覆盖真实分布、独立复测能否持续,都是它能否长期立住的关键。至少现在,行业有了一个可以开始争论的共同起点。
相关链接
- InclusionMed 官网:https://inclusionmed.ai
本文地址:https://www.163264.com/21844