匿名模型 Gestalt 登顶设计榜:Elo 1931,把 Claude 和 GPT 都甩在身后
设计圈这两天在传一张榜单:第一名不是 Claude,也不是 GPT,而是一个代号叫 Gestal…

文章目录
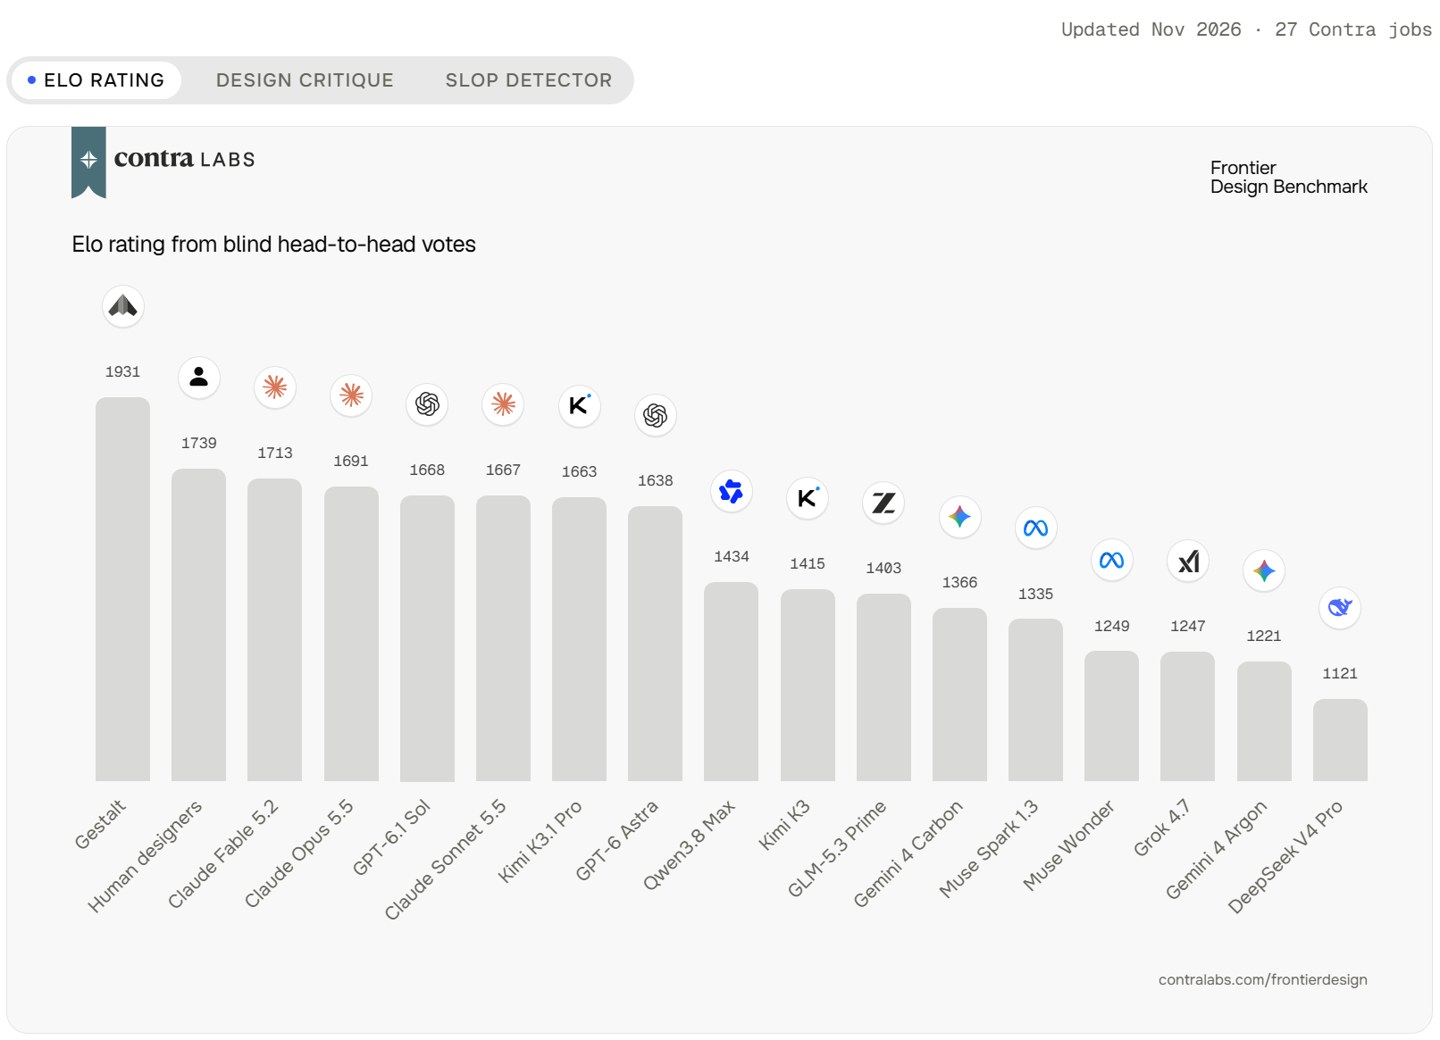
设计圈这两天在传一张榜单:第一名不是 Claude,也不是 GPT,而是一个代号叫 Gestalt、连开发团队都没公开的匿名模型。它在一个专门评测“真实商业设计任务”的榜单上,拿到了 1931 的 Elo 评分和 90% 的胜率。
发布榜单的是 Contra Labs。评测名为 Frontier Design Benchmark,当地时间 11 月 18 日公布。它的特别之处在于,考的不是“能不能生成一张好看的图”,而是能不能完成真实的设计委托。
一分钟速览
- Gestalt 以 Elo 1931 分、90% 胜率排名第一,状态标记为 Stealth(隐身开发)。
- 人类设计师参考作品以 1739 分排第二,胜率 74%。
- Claude Fable 5.2 以 1713 分排第三,GPT-6.1 Sol 以 1668 分排第五。
- 评测共 33 项任务,27 项来自真实设计委托,6 项来自创业公司合作项目。
- 35 名专业设计师参与,5 轮盲测累计投出 4311 票。
它赢的不只是“好看”,而是“像人做的”
这项评测由 Contra Labs 与 BenchFlow 合作推出,任务不是简单的提示词生成,而是从 Contra 平台上的真实设计委托里改编而来,涵盖色彩、字体、布局、可用性以及对任务要求的遵循程度。评价体系有三层:设计师双盲偏好投票、设计质量评价体系(Design Critique Rubric),以及一个专门识别 AI 痕迹的 Slop Detector。
结果最有意思的地方,是三个指标并不同步。按设计师偏好算,Gestalt 明显领先;但在设计质量评分上,它拿到 83 分,Claude Fable 5.2 和 Claude Opus 5.5 都是 84 分,人类参考作品只有 74 分。也就是说,专业评审认为 Claude 的执行质量略高,但设计师在盲测时更愿意选 Gestalt。
Contra Labs 对此的解释是:审美偏好和具体执行质量不是一回事。人类参考作品确实存在一些能明确指出的问题,但在盲测里依然拿到了不少偏好票。这句话其实点破了设计评测的难点——好看、正确、可用,本来是三个维度,硬压成一个分数就会互相打架。
28 次正面对决,人类赢了 8 次
在 Gestalt 与人类设计师参考作品的直接比较中,35 名设计师在 28 次对决里有 20 次选择了 Gestalt。这个数字很扎眼,但也不必过度解读:样本只有 28 次,任务集中在 Contra 平台上的商业设计类型,而且人类参考作品是固定的一组,不是针对每个任务重新找顶级设计师定制。
更值得关注的是 AI 痕迹检测。Gestalt 的生成结果在 Slop Detector 上的评分接近人类参考作品,说明它输出的东西不那么容易被一眼看出是 AI 做的。对商业设计来说,这既是能力,也是风险:当“像人做的”成为可量化指标,平台和客户就需要新的方式来确认作品的来源与授权。
匿名模型为什么总能抢头条
Gestalt 目前被标记为 Stealth,架构、团队、参数一概未公开。这种“先上榜、后揭面”的打法,在大模型圈已经成了固定套路:用匿名身份参加公开评测,既能试探市场反应,也能避免过早被对手针对。
但对榜单本身来说,匿名是把双刃剑。一方面,它制造了话题和悬念;另一方面,无法复现、无法审计的模型,很难成为行业基准。Contra Labs 只公布了评分和部分任务信息,没有开放 Gestalt 的调用入口,外界也无法验证它在其他设计任务上的稳定性。
趋势:设计可能是 AI 最先“越界”的创意工种
比起编程和数学,设计长期被认为是 AI 更难替代的领域,因为它依赖审美、语境和客户沟通。但这份榜单至少说明,在结构相对清晰、评价标准可以拆解的商业设计任务上,模型已经能和人类参考作品正面竞争。
真正的分水岭不在榜单,而在工作流。客户会不会接受 AI 主导的初稿,设计师会不会把重复排版和变体生成交给模型,版权和署名怎么算,这些问题的答案,比 1931 分更能决定行业走向。Gestalt 是谁,或许很快就没那么重要了;重要的是,它证明了这个位置有人能坐上去。
本文地址:https://www.163264.com/22260