GPT-6.2 Astra 再测具身智能:16 项任务成功率从 19.6% 涨到 41.2%,打结、叠衣首次通关
机器人基础设施公司 XDOF 的 Ember-0 基准实测显示,GPT-6.2 Astra 的综…

文章目录
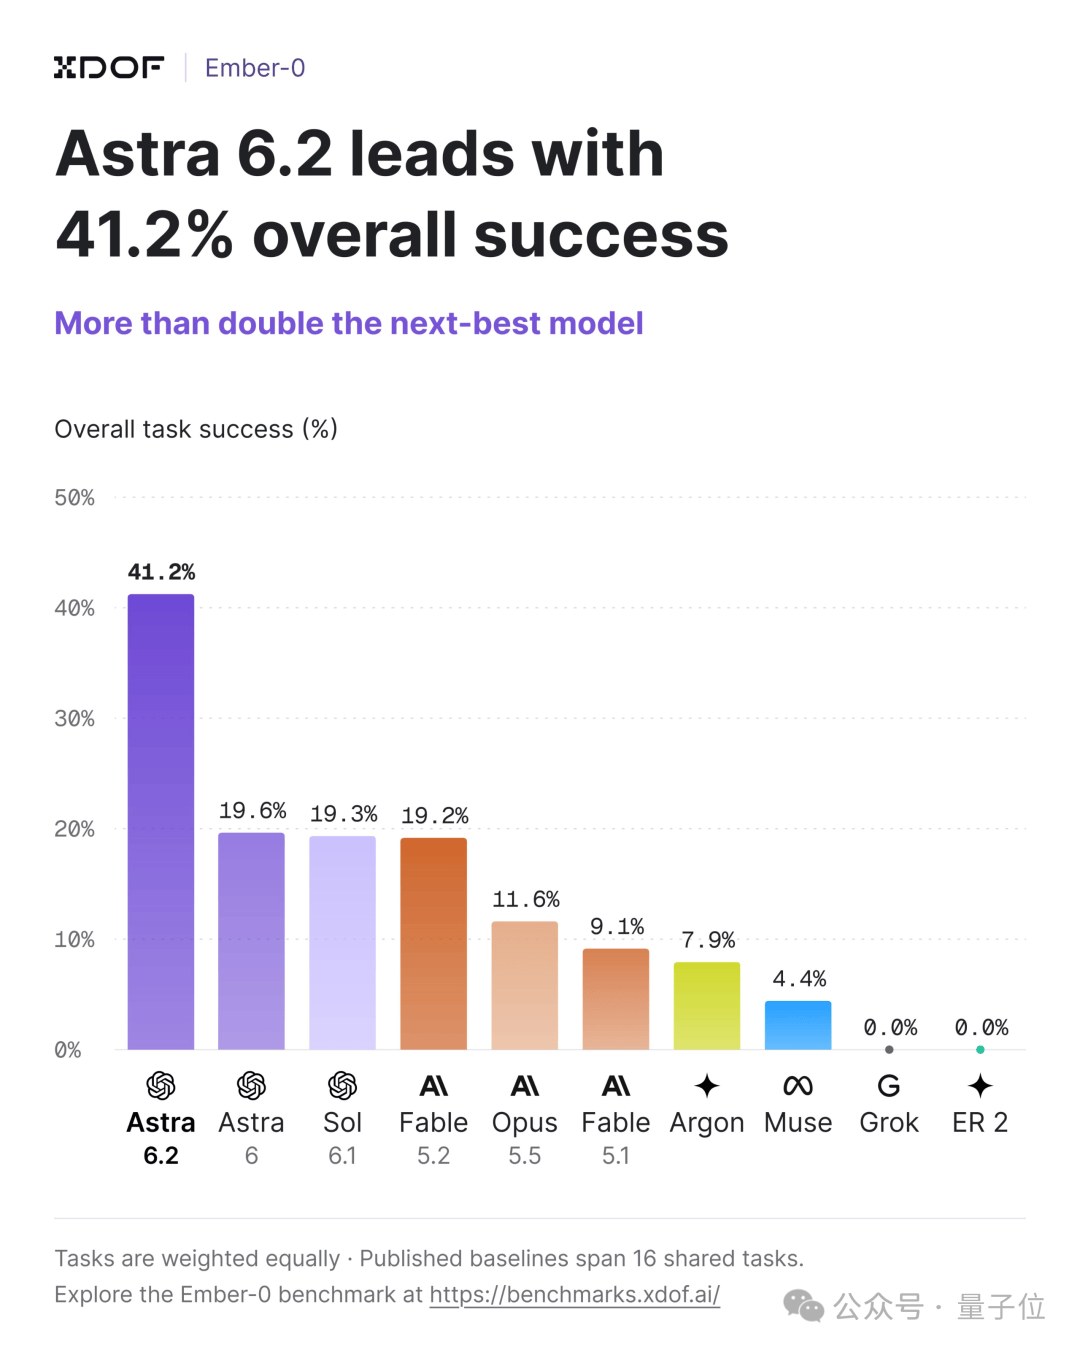
机器人到底有没有变聪明,靠发布会上的演示视频很难判断。11 月 21 日,机器人基础设施公司 XDOF 给出了一组更接近工程实测的数据:在双臂机器人基准 Ember-0 上,GPT-6.2 Astra 的 16 项操作任务综合成功率从两个月前 GPT-6 Astra 的 19.6% 提升到 41.2%,翻了一倍还多。
一分钟速览
- 测试覆盖抓取、空间推理、双臂协作、工具使用、精细操作与柔性物体处理。
- 六台 YAM 工作站并行,每项任务重复 30 次,单日可完成 480 场实测。
- 「给绳子打结」和「展开 T 恤」两项此前无模型通关的任务,这次被拿下。
- 夹起面包的成功率从 10% 跃升到 90%,说明提升不是单点运气。
这 41.2% 是怎么算出来的
Ember-0 不是实验室里摆拍的演示,而是一套面向真实物理环境的评测协议。它要求双臂机器人完成 16 项操作任务,每项重复 30 次,再由人工标注子步骤、抓取失误与碰撞,尽量滤掉硬件偏差和随机扰动。最终分数是 16 项任务成功率的等权平均,因此很难靠某一项「刷分」把总分拉起来。
XDOF 用六台 YAM 工作站并行试验,单日能跑完 480 场实测。这种规模意味着结果具备一定统计意义,而不是挑一条成功视频发出来。更值得注意的是,GPT-6.2 Astra 的进步分布在整套测试里:需要物理推理的「拉动毛巾取回远处毛绒玩具」「倾斜托盘让球滚入碗中」,考验记忆与感知的「寻找被遮挡马克笔」「遵循红色便签上的隐藏指令」,以及考验精细力控的「不捏碎薯片并移动」「用夹子夹起面包」「端麦片上托盘」,完成度都有明显抬升。
打结和叠衣服为什么难
以 Diffusion Policy、ACT、RT-2 为代表的视觉—语言—动作模型,通常依赖大量人类示教数据。刚性物体形状稳定,抓取位置和运动轨迹容易预测,训练后能形成较稳的策略。但柔性物体每一步接触都会改变形态:布料会褶皱、绳结会滑动,机器人必须从腕部和顶部摄像头持续判断角点、纹理与整体形状,再决定下一次动作。抓取点偏一厘米,任务就可能前功尽弃。
此前 Ember-0 累计做过 143 次有效的 T 恤展开测试,没有任何模型成功。这次 GPT-6.2 Astra 把两个「零的突破」一起补上,说明模型对柔性物体形变的建模能力确实往前走了一步。用夹子夹面包从 10% 到 90% 的跳变,则更像是精细力控与视觉闭环同时改善的结果。
离「能干活」还有多远
41.2% 不是及格线,更不是商业化门槛。真实产线要求的是 99% 以上的稳定性和可预测的失败模式,而当前模型仍会在长程任务中累积误差。XDOF 自己也承认,Ember-0 基准可能不久后就会被模型能力饱和,届时要设计更难的测试,才能继续区分模型高低。
但方向已经清楚:具身智能的竞争,正在从「能不能演示一个动作」转向「能不能在标准化协议下稳定复现」。谁能在同一条尺子上持续进步,谁才更接近真正的通用机器人。对 OpenAI 来说,GPT-6.2 Astra 在语言与推理上的升级,正在以可测量的方式外溢到物理世界;对行业来说,一套公开、可复跑的基准,比任何宣传片都更有价值。
本文地址:https://www.163264.com/22380