SSD 里塞进 NPU 和 64GB 内存:群联想让硬盘自己跑 AI 模型
群联在 SC26 展示两款面向 AI 的企业级 SSD,其中一款内置 NPU、64GB 内存与 …

文章目录
一分钟速览
- 群联在 SC26 大会展示两款专为 AI 场景设计的企业级 SSD。
- 其中一款内置 NPU、64GB 内存,带宽达 130GB/s,可直接运行 PyTorch、vLLM、OpenVINO、llama.cpp。
- 设计思路是把计算搬到存储侧:硬盘直接处理数据,只把结果回传给主机,特定负载下数据传输量可减少 10 至 100 倍。
- 另一款采用 pSLC + QLC 混合介质与 16 通道主控,用一块盘替代独立缓存盘。
当硬盘开始”思考”
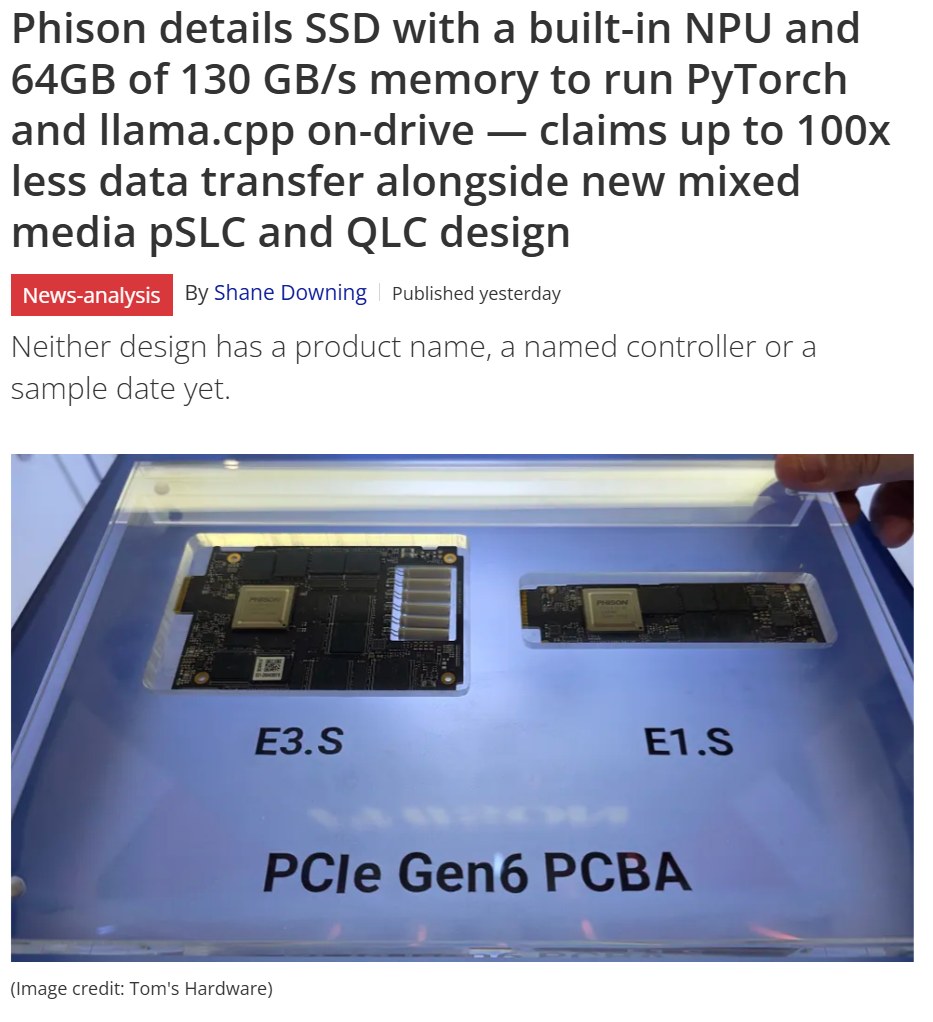
据科技媒体 Tom’s Hardware 报道,群联在 SC26 大会上展示了两款面向 AI 的企业级固态硬盘。其中最引人注目的一款,把 NPU、64GB 内存和 130GB/s 的带宽塞进了标准的硬盘形态里,并且可以直接在盘上运行 PyTorch、vLLM、OpenVINO 和 llama.cpp 等主流框架与推理工具。
这不是概念渲染图,而是一套明确的架构主张:让存储设备具备本地计算能力,把原本必须”搬来搬去”的数据留在原地处理。
为什么要让 SSD 自己算
在典型的 AI 推理流水线里,数据从存储读到主机内存、再送进 GPU 或加速卡,中间要经过多次拷贝。模型越大、数据集越宽,搬运本身占用的带宽和时间就越可观。群联的方案把一部分计算任务从服务器转移到 SSD 上:设备直接处理自己保存的数据,只向主机返回结果,不必完整传输数据集。
按照群联的说法,在特定工作负载下,这套设计有望把数据传输量减少 10 到 100 倍,同时降低主机 CPU 的负载。对于被 I/O 卡住脖子的推理集群来说,这个数字比单纯的顺序读写跑分更有意义。
当然,需要冷静看待的是”特定工作负载”这个限定词。能在盘上运行的模型规模受制于 64GB 内存与 NPU 算力,适合的是嵌入检索、预处理、轻量推理这类场景,而不是替代 GPU 训练集群。它的价值在于把数据管道里最琐碎的一段就地消化掉。
另一条路线:混合介质替代独立缓存盘
同场展示的第二款产品走的是介质路线。它采用全新的 Mixed Media 混合介质设计,把高耐久性的 pSLC 缓存与大容量 QLC 闪存放在同一块 SSD 中,由一颗 16 通道主控统一管理。
具体做法是把部分 QLC 闪存切换到 SLC 工作模式,用容量换取写入性能与耐久度。两块存储区域各自分配独立命名空间,主机可以按数据类型选择落点,不需要额外安装专用软件。
群联给出的收益很直观:在包含 24 块 SSD 的系统中,如果其中一块硬盘故障,缓存损失比例约为 4%;而传统用 4 块独立缓存盘的方案,一旦坏掉一块,可能损失 25% 的缓存容量。对规模化部署来说,这是可靠性层面的实打实差异。
存储厂商为什么集体向上走
过去两年,AI 基础设施的竞争焦点集中在 GPU、HBM 和互连网络上,存储更多被当作”够快就行”的配套。但随着推理负载规模化,数据搬运的成本开始显性化,存储厂商找到了新的叙事入口:既然数据在我这里,为什么不能在这里算完再走?
这条”存算一体”的路线并不新鲜,难点一直在生态。硬件上塞进 NPU 不难,难的是让 PyTorch、vLLM 这些框架真的愿意把算子卸载过去,并且性能不倒退。群联选择直接兼容主流框架,本质上是在降低开发者的迁移门槛。
三点判断
其一,短期看是”卸载”,不是”替代”。盘内算力更适合承担数据预处理、向量检索、轻量模型推理等边缘环节,核心训练仍然属于 GPU 集群。
其二,真正的门槛在软件栈。框架兼容只是第一步,调度器是否愿意把任务切给一块硬盘、出错时如何回退,才是决定这套方案能否进入生产环境的关键。
其三,企业采购会先看 TCO。减少数据搬运意味着更少的网络带宽、更低的 CPU 占用和更紧凑的机架布局,这些都能折算成成本。只要实测收益站得住,存储侧计算就有机会从展台走进机房。
从”存得下”到”算得动”,硬盘的角色正在被重新定义。群联这次的展示未必马上变成订单,但它指出了一个方向:AI 基础设施的下一轮优化,可能发生在最不起眼的那一层。
本文地址:https://www.163264.com/22502