Agent 开始直接查数据库:腾讯云把「企业语义」做成了数据库的一层
过去数据库的用户是人:需求先被翻译成 SQL,再被执行。现在 Agent 也坐到了这张桌子前,但…

文章目录
过去数据库的用户是人:需求先被翻译成 SQL,再被执行。现在 Agent 也坐到了这张桌子前,但它不会读业务口径,也不知道“收入”在两个表里指的是两件不同的事。
一分钟速览
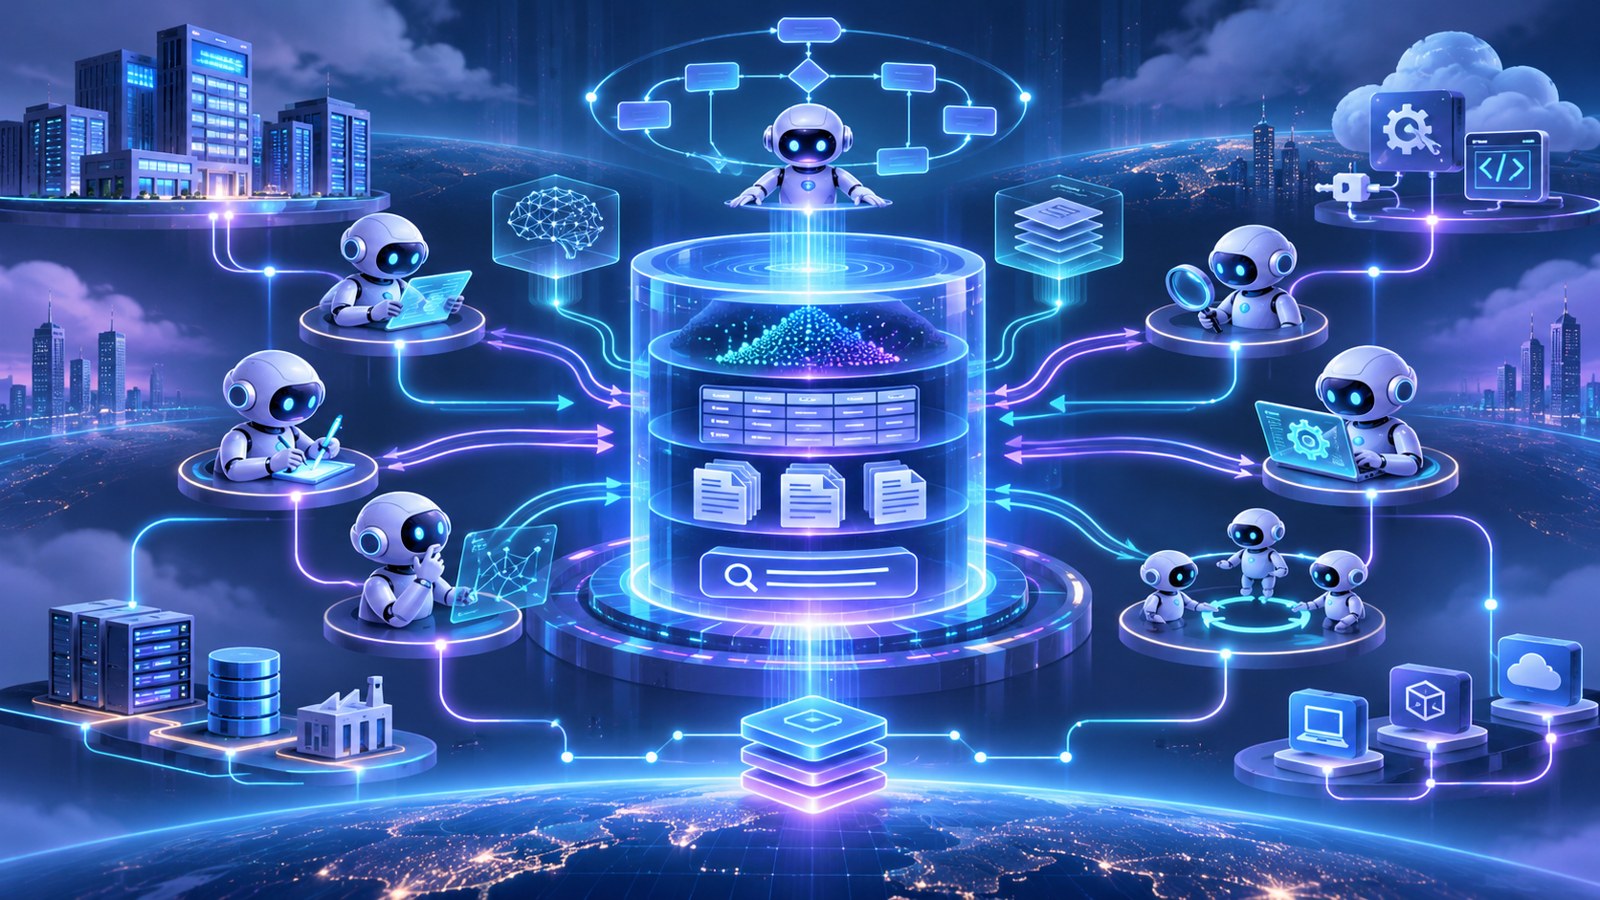
- 腾讯云 TDSQL Nexa Lakebase 以对象存储为底座,采用 Iceberg、Lance 开放表格式,GooseFS 做分布式缓存
- 宽表、搜索、分析、AI 计算四类引擎可插拔,NTS 负责外部接入与内部流转
- 上层智能编排路由按代价模型选择引擎,对外提供 SQL、REST、MCP 三种入口
- Nexa Knowledge 把表结构、指标口径、术语、专家经验沉淀为五类知识资产
- 支持 ShortCut 联邦查询,MySQL、PostgreSQL、MongoDB、COS 可原地访问
两个老问题,在 Agent 时代变尖锐
第一个是数据孤岛。订单和交易在关系型数据库,文档和图片在对象存储,日志在别的地方,每套系统各有一套查询方式。人来做分析,可以靠经验串起来;Agent 来做,第一步就卡在“去哪儿找”。
第二个是语义缺口。表名、字段名、类型只能描述结构,描述不了业务规则。数据库里可能同时存在三个“收入”字段,口径分别是含税、不含税、确认收入。仅凭字段名,模型只能猜。
Gartner 今年的分析也提到,企业语义是影响 Agent 准确性的重要因素。Agent 要完成一次查询,既要找对数据,也要守对口径;任务链越长、跨系统越频繁,对底层数据组织和知识管理的要求越高。
把四种引擎装进一套架构
TDSQL Nexa 的做法是“少搬数据”。底层用对象存储承载海量原始数据与加工产物,计算层放四种引擎:宽表引擎管特征、标签和业务数据;搜索引擎管向量、全文与多条件过滤;分析引擎用 MPP 与向量化执行跑大规模分析;AI 计算引擎管多模态加工,统一纳管 CPU 与 GPU。
中间层 NTS 负责两件事:把 MySQL、PostgreSQL、MongoDB 的数据同步进来,以及在内部引擎之间搬运,比如宽表数据同步到搜索与分析引擎,供向量检索和报表复用。这样同一份业务数据能支持不同查询,不必在应用层反复拼接。
对暂时不想迁移的企业,ShortCut 提供联邦访问,直接查原系统。是原地访问还是同步纳管,按实时性、性能和治理需求选。
知识层才是差异化的地方
多引擎解决“找得到”,Knowledge 解决“读得懂”。Nexa Knowledge 先从已有数据库提取表、字段与关联关系,建立基础语义;企业再补充指标定义、业务术语、规则、文档和专家经验,系统把这些材料整理成 Skill、术语、澄清规则、已验证问答、世界事实五类资产。
Agent 接到任务时,先检索相关知识,再决定用哪些表、遵循什么口径、采用什么查询方法。这比让模型从字段名硬猜要稳得多。更关键的是它会持续更新:字段变了、口径调了、查询中发现语义偏差,都可以重新沉淀回知识库。
这一步其实是在给企业补一门“数据通识课”。过去这些知识散在老员工的脑子和文档里,现在被要求写成 Agent 能检索的形式。
趋势判断
数据库正在从“存储与查询系统”变成“Agent 的数据接口与语义层”。MCP 这类协议会成为标准入口,谁能把权限、语义、成本控制一起做好,谁就更容易被 Agent 调用。
真正的难点不在引擎数量,而在语义维护的长期成本。知识库一旦没人更新,Agent 会用过时的口径给出看起来很确定的错误答案——这比查不到数据更危险。
本文地址:https://www.163264.com/19224