Meta 让美国用户和 AI 头像视频通话了:Muse 长出“表情”,年底还要上硬件
过去和 AI 语音助手说话,体验更像是“对着空气提问”:你说话,它回答,中间没有任何表情。 Mu…

文章目录
过去和 AI 语音助手说话,体验更像是“对着空气提问”:你说话,它回答,中间没有任何表情。
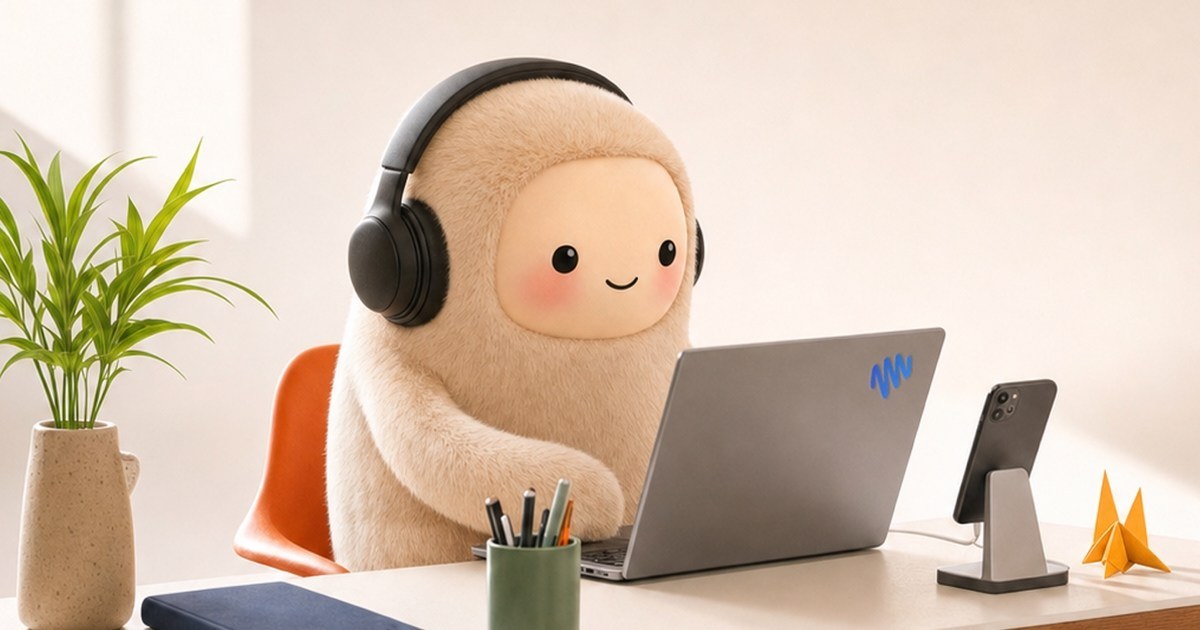
Meta 想改的是这一点。11 月 5 日,公司宣布 Muse Voice 向美国所有用户开放——现在你可以给 Muse 打电话,也可以和它的虚拟头像视频通话。
一分钟速览
- Muse Voice 已向美国全体用户开放,支持通话与视频聊天。
- 功能在 9 月的 Connect 大会上首次亮相,背后是 Muse Realtime Avatar 与 Muse Realtime Voice 两套模型。
- 默认头像是一只叫 Jolly 的动画小生物,用户可自定义成人、动物或其他角色。
- 说话时头像会做出与语气匹配的细微表情和手势;它听得到用户,但看不到。
- 已支持移动端、网页和 Mac,后续将进入 AI 眼镜与年底推出的 Muse Charm 硬件。
为什么给 AI 一张脸
Meta 的解释是“拟人化能让人更有连接感”。这话听起来像营销,但放在产品逻辑里说得通:语音助手最大的问题是存在感太弱,用户不知道它在听、在思考、还是在走神。
一个会眨眼、会歪头、会在你讲笑话时配合表情的动画形象,能补上这部分反馈。Meta 说这些表情和手势会跟随对话语气变化——不是随机播放动画,而是跟语义挂钩。
需要说明的是,Muse 并不“看见”用户。摄像头开着,但它不读取画面,只处理声音。这个设定既降低了隐私争议,也降低了技术难度。
一个狗头像的演示
这次发布由 Meta 首席 AI 官 Alexandr Wang 在 X 上公布,他放了一段自己与 Muse 的演示。视频里他聊到自己在 X 上爱发梗图,还跟 Muse 开玩笑说这可能惹老板不高兴。
他的 Muse 是一只毛茸茸的白狗,回应是建议他给那些可能被误解为 Meta 背书的梗图加上免责声明。这段对话本身没什么信息量,但它展示了产品想要的效果:有来有回、有性格、不像在念稿。
硬件才是真正的落点
视频通话只是一个中间形态。Meta 已经确认,年底前会推出一款类似 Tamagotchi 的可穿戴设备,专为 Muse 设计。设备到了之后,虚拟头像会出现在小屏幕上,用户可以直接和它说话,让它回答或执行任务。
把这两件事连起来看,路径就清楚了:先在手机和电脑上把“有脸的实时对话”跑通,再把同一个形象搬到随身硬件上。用户在手机上养成的习惯,会成为硬件的第一批使用场景。
这也是 Meta 相比纯软件公司的优势——它有眼镜、有硬件团队、有分发渠道。AI 助手的竞争到最后,可能不是比谁的模型更聪明,而是比谁能让这个助手随时在场。
实时头像,正在变成基础设施
值得注意的是底层模型的名字:Muse Realtime Avatar、Muse Realtime Voice。“Realtime”被放进产品名,说明延迟是核心指标。视频通话对延迟的容忍度远低于文字对话,超过一秒的停顿就会破坏“在对话”的感觉。
这类能力的成本目前还不低,但方向明确:当实时语音和实时形象变成标配,AI 产品的形态会从“打开一个 App 提问”变成“身边一直有个存在”。Meta 押的是后者,而它手里的硬件,正是为这个判断准备的位置。
本文地址:https://www.163264.com/19470