Google Gemini 编辑推荐
纸上随手画几笔,Gemini 就能把它变成能点的 App
Google 官方博客在 11 月 5 日放出一则很短的演示:把随手画在纸上的界面草图拍下来,交…

文章目录
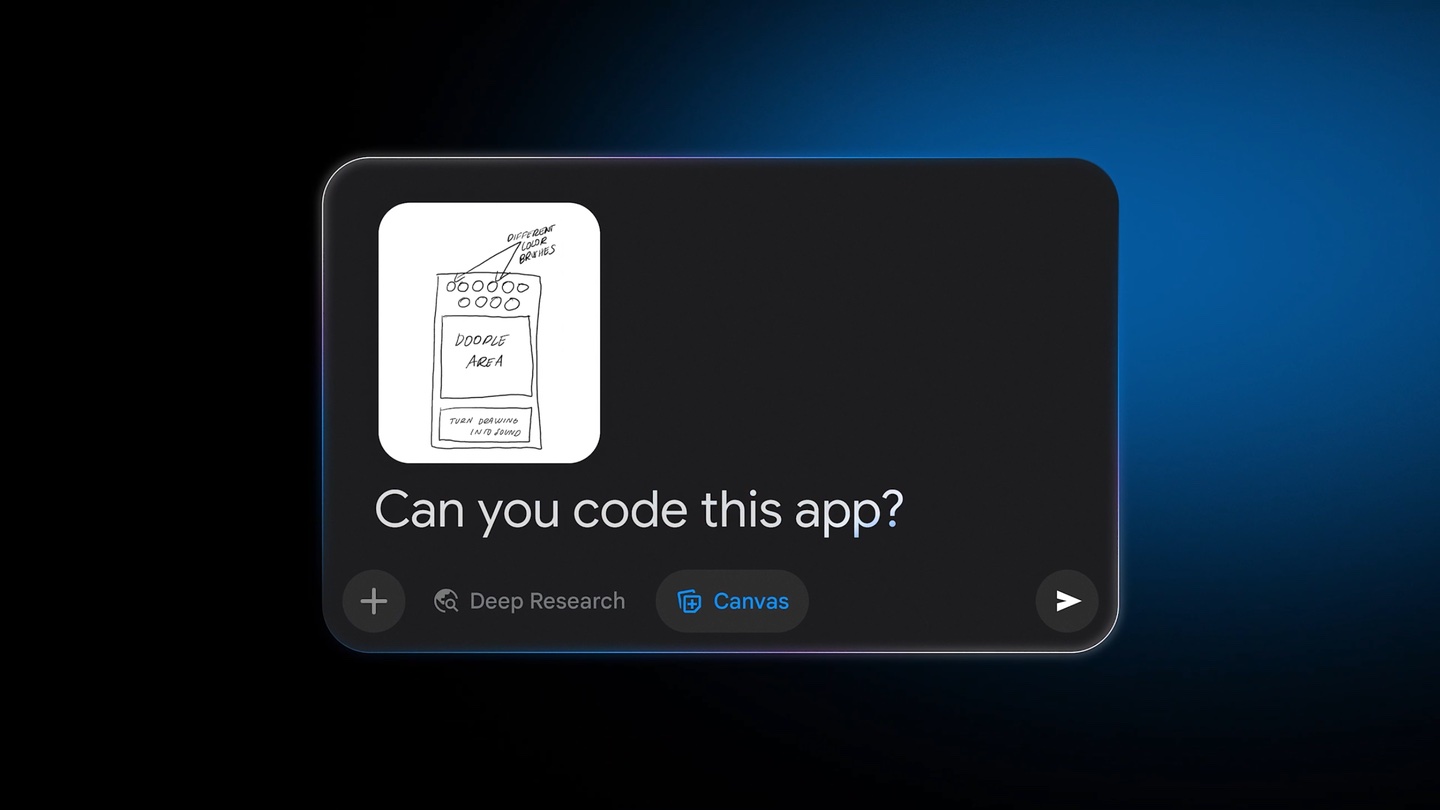
Google 官方博客在 11 月 5 日放出一则很短的演示:把随手画在纸上的界面草图拍下来,交给 Gemini App 里的 Canvas,它就能生成一个可以点击、可以跑起来的应用原型,之后还能继续用对话改代码。
核心看点
- 入口是 Canvas,不是新模型。官方给出的步骤只有一句:把画好的图上传到 Canvas 工具,即时生成并迭代代码。没有新的订阅档位,也没有单独的开发者平台。
- 草图被当成”需求文档”。纸上的方框、按钮、标题栏位置,会成为模型理解界面结构的线索,而不是被当成一张要临摹的图片。
- 和 Gemini Omni 1.2 Flash 同一天发布。一边是 15 秒视频生成,一边是草图变应用,Google 想讲的是同一条链路:把”想清楚”到”做出来”之间的那段体力活交出去。
为什么这个演示值得看一眼
过去一年,AI 写代码的能力涨得很快,但卡点往往不在代码本身,而在”把脑子里的界面描述清楚”。文字描述一个三栏布局,写十句话对方也未必懂;画三根线,谁都懂。
Canvas 这个用法把输入方式降到了最低成本:一张餐巾纸、一个白板角落、手机拍的照片。对产品经理、独立开发者、要给学生做演示的老师来说,这比”先学一套提示词模板”现实得多。
更实际的变化是迭代方式。原型生成之后,改的是对话里的那句”把这个按钮挪到右上角”,而不是回头重画一张图。草图负责定方向,对话负责修细节,这个分工比一次性生成更接近真实的做产品过程。
边界在哪
先说清楚它不是什么:生成的是前端原型,能点、能展示交互,但真实的数据、登录、支付、后端逻辑仍然要人来补。草图画得越随意,模型对结构的猜测空间越大,返工也越多;想让结果靠谱,至少把主要区块和信息层级画清楚。
另外,原型代码需要自己过一遍。模型生成的界面通常在视觉上过得去,但状态管理、边界条件这些地方容易偷懒,直接上线是要出事的。
总结
这不是一个”AI 又取代程序员”的故事,而是一个输入方式被改写的小信号:当草图可以直接变成可运行的东西,做原型的门槛就从”会写代码”降到了”能把想法画出来”。对大多数不写代码的人来说,这才是生成式 AI 真正好用的那一面。
本文地址:https://www.163264.com/19641