32MB 就能开口说话:Underdog 把语音模型塞进网页,离线也能念出你打的每个字
打开一个网页,不联网,点一下桌上的台灯,它会响;在打字机上敲一句话,页面会用合成的嗓音念出来;转…

文章目录
打开一个网页,不联网,点一下桌上的台灯,它会响;在打字机上敲一句话,页面会用合成的嗓音念出来;转动旋钮,还能听到不同风格的音乐。这个看起来像早期网页小游戏的场景,背后跑的是一个只有 32MB 的语音模型。
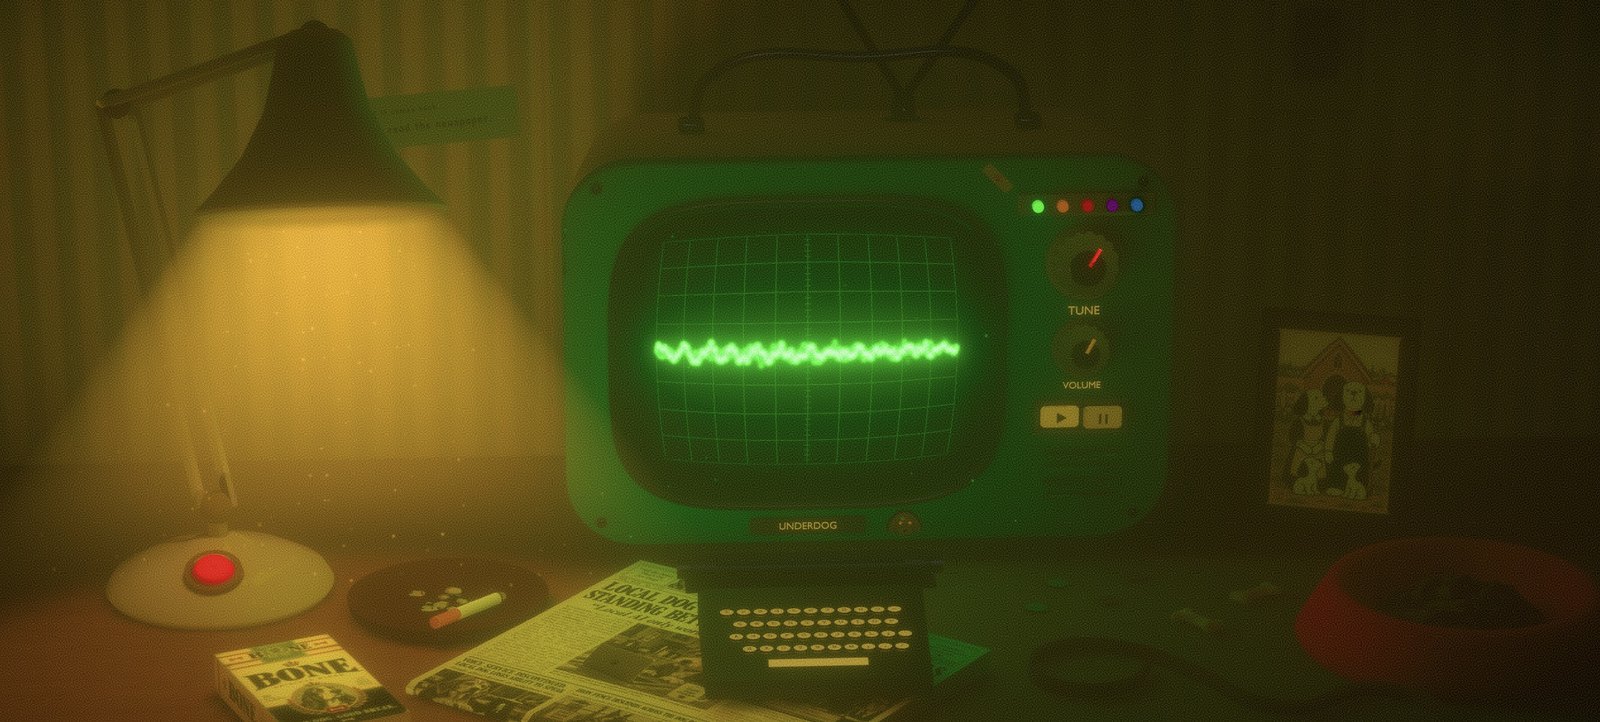
做出它的是创业公司 Underdog。它把新的文本转语音模型取名 Woof,参数规模 3170 万,模型文件 31.7MB,任何人都可以下载。为了说明能力,团队干脆做了一个小游戏:房间里摆着 CRT 显示器、打字机和调音台,所有声音都由 Woof 现场生成。开场那句“小心镇上那些爱插手的云服务商”,显然是在对云端大模型喊话。
一分钟速览
- Underdog 发布 32MB 文本转语音模型 Woof,参数约 3170 万。
- 模型可以在浏览器和多数设备上离线运行,已开放下载。
- 官方用网页小游戏演示:任意输入文字都能即时朗读。
- 此前该公司还发布过 167MB 的语音转文字模型 Bark。
- 小模型不追求全面替代大模型,而是争夺端侧助手、个性化音频等场景。
为什么“小”突然成了卖点
过去两年,语音模型的竞争主线是“更像人”:更大的参数量、更丰富的情感、更自然的口音。代价是推理必须放在云端,用户每说一句话,声音就要上传一次,延迟、带宽和隐私都成了隐形成本。Woof 走的是反方向:把模型压到几十兆,让它直接待在设备里。
31.7MB 是什么概念?一首无损歌曲大约 30MB,一张手机照片常见 3 到 8MB。这个体量意味着模型可以跟着网页一起加载,也可以塞进应用安装包,不需要单独的下载流程。Underdog 强调,它在大多数设备上不联网也能跑,这对网络不稳定地区和注重隐私的用户尤其有吸引力。
演示很讨巧,短板也很明显
用游戏来展示语音模型,是一种聪明的产品语言。语音合成最怕“念稿感”,而打字机让你输入任意内容,调音台让你听到模型在音乐上的边界,互动本身就把“能生成什么”讲清楚了。但从演示走到产品,还有几道坎:小模型的音色稳定性、长句韵律、多语言支持,通常都弱于云端大模型;在没有独立加速器的设备上,实时性也要看具体硬件。
更现实的定位,是它不必成为“最好的语音模型”,只要成为“够用的本地语音层”。本地助手唤醒、离线播报、个性化播客、儿童故事机、无障碍朗读,这些场景对音质的要求没有有声书那么苛刻,却对延迟、成本和隐私非常敏感。
端侧语音栈正在成形
把 Woof 和 Bark 放在一起看,Underdog 的路线就清楚了:一个负责听,一个负责说,两个模型都以“能在端侧跑”为前提。这套组合如果打磨成熟,开发者不依赖云端 API,就能做出完整的语音交互闭环。对平台型公司来说,语音入口可以脱离网络;对创业公司来说,不必先买一大堆 GPU 才能开始做产品。
当然,端侧模型也有自己的天花板。设备内存、发热、功耗都是硬约束,模型越大,能覆盖的机型越少。真正的工程难点不在于把模型压小,而在于压缩之后还能保持可用的一致体验,这需要针对不同芯片做量化、裁剪和调度。
趋势洞察
大模型不会因为小模型出现而消失,但分工正在变得清晰:复杂的理解、长上下文推理继续放在云端,高频、低延迟、涉及隐私的感知与生成,会逐步下沉到设备。语音是最先被推动的一环,因为它天生要求实时。接下来值得观察的,不是 Woof 能不能打败云端语音合成,而是会不会有更多应用把“离线可用”当成默认配置,而不是一句营销话术。
本文地址:https://www.163264.com/19667