豆包工作接入 DeepSeek、Kimi、GLM:模型列表开始标「倍率」
豆包工作完成产品更新,首批引入 Kimi K3.1 Pro、GLM 5.3、DeepSeek V…

文章目录
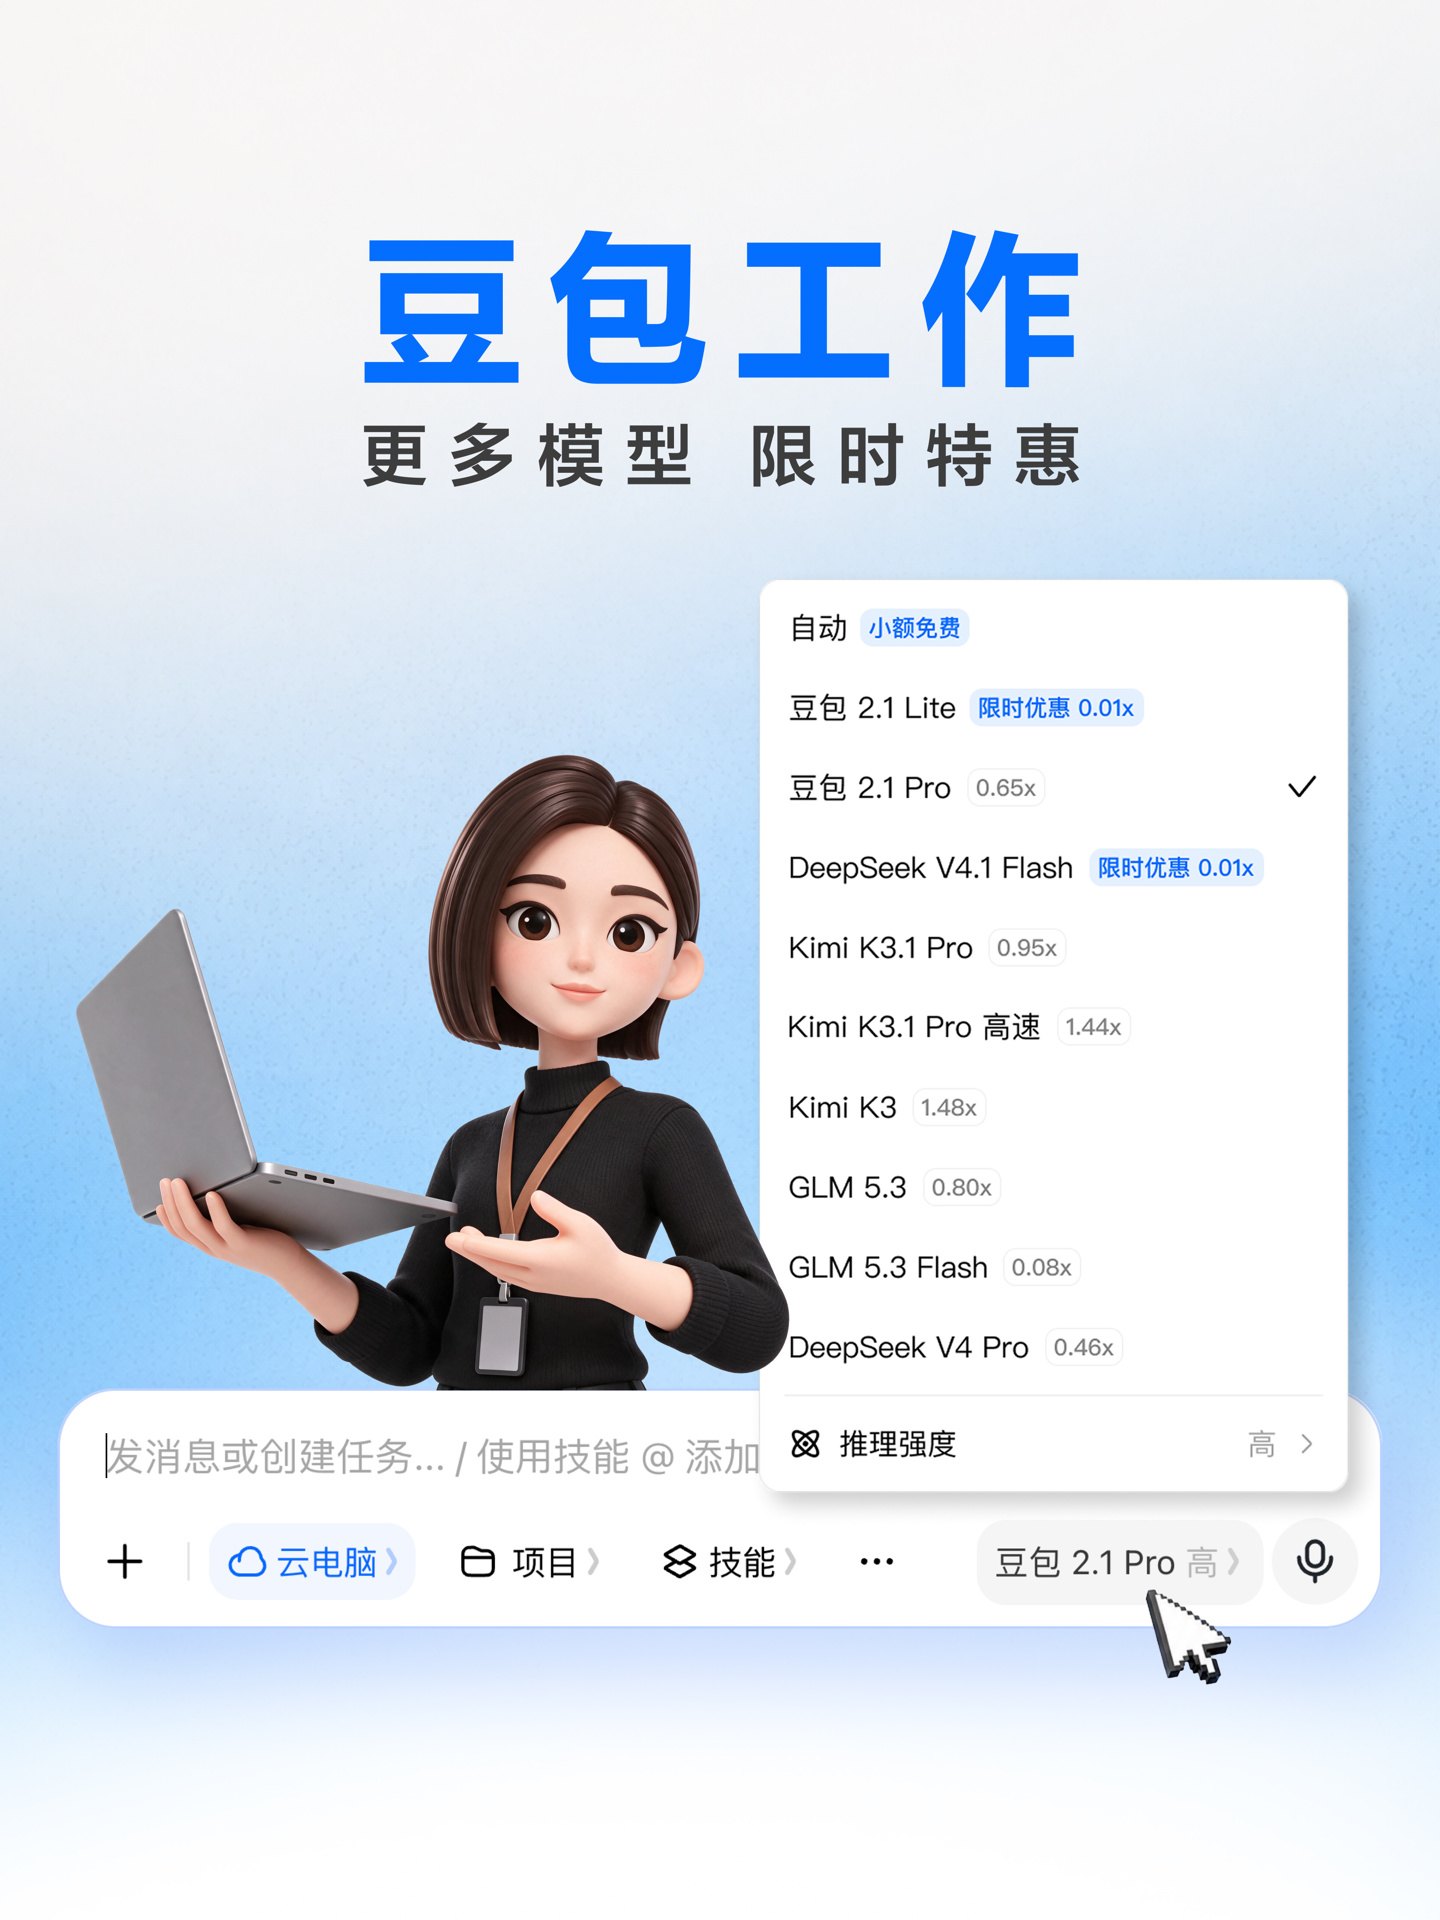
豆包官方在 11 月 12 日宣布,豆包工作完成一次产品更新:拓展更多可调用的模型,同时引入一套按实际消耗计价的额度调节机制。此前,豆包工作在模型侧只提供豆包 2.1 Lite 和豆包 2.1 Pro 两款自研模型。
一分钟速览
- 首批第三方模型为 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash。
- 用户可在自研模型与第三方模型之间按任务需要切换。
- 模型选择页直接标注每款模型的「额度消耗倍率」。
- 工作日及节假日指定时段使用参与活动的模型可享额度折扣。
- 豆包 2.1 Lite 与 DeepSeek V4.1 Flash 的倍率被下调,小额任务仍保持免费。
从「只能用自家模型」到「模型货架」
豆包工作此前是一个闭环产品:工具是自家的,模型也是自家的。这次更新把它变成了一个模型货架,用户可以根据任务性质挑选。写长文档、做复杂分析时切到能力更强的模型,处理表格清洗、批量改写这类轻任务时用便宜快速的模型。
这个变化并非突然。10 月 29 日,豆包工作先向团队订阅版和企业订阅版客户开放了三方模型配置,企业不需要另外向模型厂商采购,用量直接扣已有的 AI 点数。11 月 12 日的更新把能力扩展到更广泛的用户,并配套上线限时优惠。
「倍率」是把成本翻译成用户能懂的语言
多模型带来的第一个问题就是成本不透明。同样一个任务,不同模型消耗的资源差很多,用户却很难提前判断。豆包工作的做法是在模型选择页标出倍率:系数越低,完成同一任务消耗的额度越少。
这个设计看似简单,实际解决了一个长期困扰 AI 产品的问题——计价单位。按 Token 计费,普通用户根本不知道一次对话烧了多少;按次数计费,又无法反映任务复杂度。倍率相当于给每个模型贴了一个「油耗标签」,用户在效果、速度和成本之间做取舍时,至少有了可见的依据。
多模型策略背后的现实
对字节来说,接入第三方模型是一笔划算的账。自研模型覆盖主力场景,第三方模型补齐长尾能力,既不用在每个方向都追到最前沿,也能让用户在遇到短板时不必换产品。对 Kimi、智谱、DeepSeek 来说,进入豆包的入口意味着触达一批原本不会主动注册的用户。
但这也带来新的问题。模型越多,质量一致性越难保证;用户在 A 模型上得到的体验,换到 B 模型可能完全不同。豆包用「自动(小额免费)」作为默认首项,由系统按任务规模匹配模型,本质上是在替用户做第一层决策。这个默认值选得好不好,会直接影响留存。
另一个观察点是定价权。当模型变成货架上的商品,用户会比较倍率,厂商之间的价格战会直接暴露在同一个界面里。谁能在同等效果下把倍率压得更低,谁就更容易被选中。这对模型厂商是压力,对用户则是实打实的红利。
本文地址:https://www.163264.com/20681