腾讯混元 Hy Realtime 发布:语音模型不只「会说话」,现在还能唱歌、自己调工具
你有没有遇到过这样的场景:开车时想找一首「2015 年左右的粤语老歌」,对着语音助手说了三遍,它…

文章目录
你有没有遇到过这样的场景:开车时想找一首「2015 年左右的粤语老歌」,对着语音助手说了三遍,它要么听成别的歌,要么干脆回一句「抱歉,我没听懂」。语音交互喊了这么多年,真正让人愿意一直聊下去的助手并不多,问题往往不在「听」,而在「懂」和「接得住」。
11 月 13 日,腾讯混元发布实时语音模型 Hy Realtime。它没有走「把语音转成文字再理解」的老路,而是把理解、表达和工具调用放在同一条实时链路上,还额外加了一项过去语音助手很少认真做的事——唱歌。
一分钟速览
- 能力升级:语音理解、指令遵循、拟人化表达三项基础能力同步提升,支持口齿含糊、话说半截、中途改口等真实对话场景。
- 会调工具:模型能根据上下文判断是否要联网搜索,把「搜索决策—调用工具—生成回答」合成一步。
- 会唱歌:与腾讯音乐 TME 灵音 AI 团队联合打磨,支持按歌手、专辑、曲风、语种、年份组合点歌,并能接着上文继续选。
- 已经落地:元宝语音通话、腾讯客服等产品上线,近期将通过腾讯云开放 API。
- 下一步:双工交互、长期个性化记忆、前后台 Agent 交互。
从「听清」到「听懂半句话」
官方披露的细节里,最有价值的一条是对「不完整输入」的处理。现实中人和人说话,很少像写作文一样完整:可能说到一半改口,可能用「就那个」「你懂的」指代前文。Hy Realtime 的做法是结合对话上下文做意图还原,而不是把每一句都当成孤立指令。官方称这类场景的理解准确率有明显提升,多轮指令遵循和上下文管理也做了加强,长对话里不容易「聊着聊着就忘了」。
这听起来像工程细节,但它决定了语音助手能不能从「一问一答」变成「持续陪聊」。用户对语音产品最大的抱怨,往往不是某一次识别错误,而是聊到第五轮时助手突然失忆。
会唱歌,是能力也是场景
Hy Realtime 与 TME 灵音 AI 团队做了深度 Co-Design,把自然语言点歌和歌声生成放进同一段对话。用户说「来首 2010 到 2020 年之间的英文民谣」,模型要同时完成三件事:理解时间范围、匹配曲风语种、在对话里接着唱下去。官方表示,演唱的情绪层次、咬字气息衔接、旋律节奏都做了针对性打磨。
这个功能看似娱乐,实际是语音模型能力的一次综合考试:要处理长上下文、要理解模糊偏好、还要在生成端保持音质和韵律。能把这三件事同时做顺,说明模型在语音链路上已经比较完整。
数据与落地
混元团队给出的评测口径包括三类:内部专家盲评的真实产品体验、覆盖数学、科学、逻辑推理、知识问答、复杂指令、文本理解、多轮的内部基础智商测试集,以及语音交互领域的多个公开 Benchmark。官方称在基础搜答类体验上有显著提升,非思考模式下的中文表现不俗,公开 Benchmark 的综合客观表现处于领先水平。
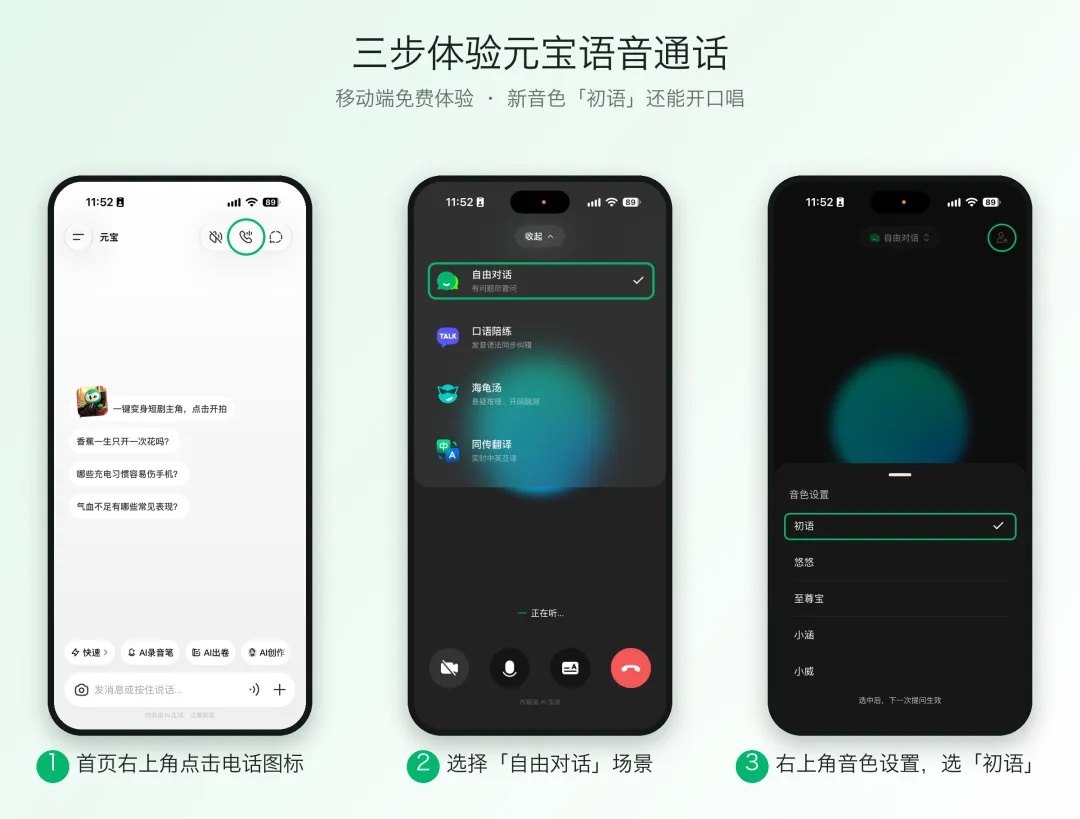
产品侧,Hy Realtime 已经在元宝 App 的语音通话里上线,选择「初语」音色即可体验;网页 Demo 也开放了部分能力。更值得关注的是腾讯云 API 的开放节奏——一旦对外开放,客服、教育、车载、陪伴类应用都可以直接接入,语音交互的门槛会再降一截。
趋势洞察
过去两年,大模型的竞争集中在「文本智商」;今年开始,战场明显转向「实时多模态」。语音是最自然的人机接口,也是最难做好的接口:延迟、打断、噪声、情绪、上下文,每一项都能让体验崩掉。腾讯选择把工具调用和唱歌一起塞进实时语音模型,本质上是在争夺「下一代入口」的定义权——不是让用户打开一个 App 问问题,而是让助手一直在线,随时能接话、能办事、还能来一段。
接下来真正的看点,是双工交互和长期记忆能不能落地。前者决定对话像不像真人,后者决定助手能不能「记住你」。这两件事做成,语音助手才算真正从工具变成伙伴。
本文地址:https://www.163264.com/20892