OpenAI 拆掉机器人团队:要让 GPT-6 Astra 直接当机器人的大脑
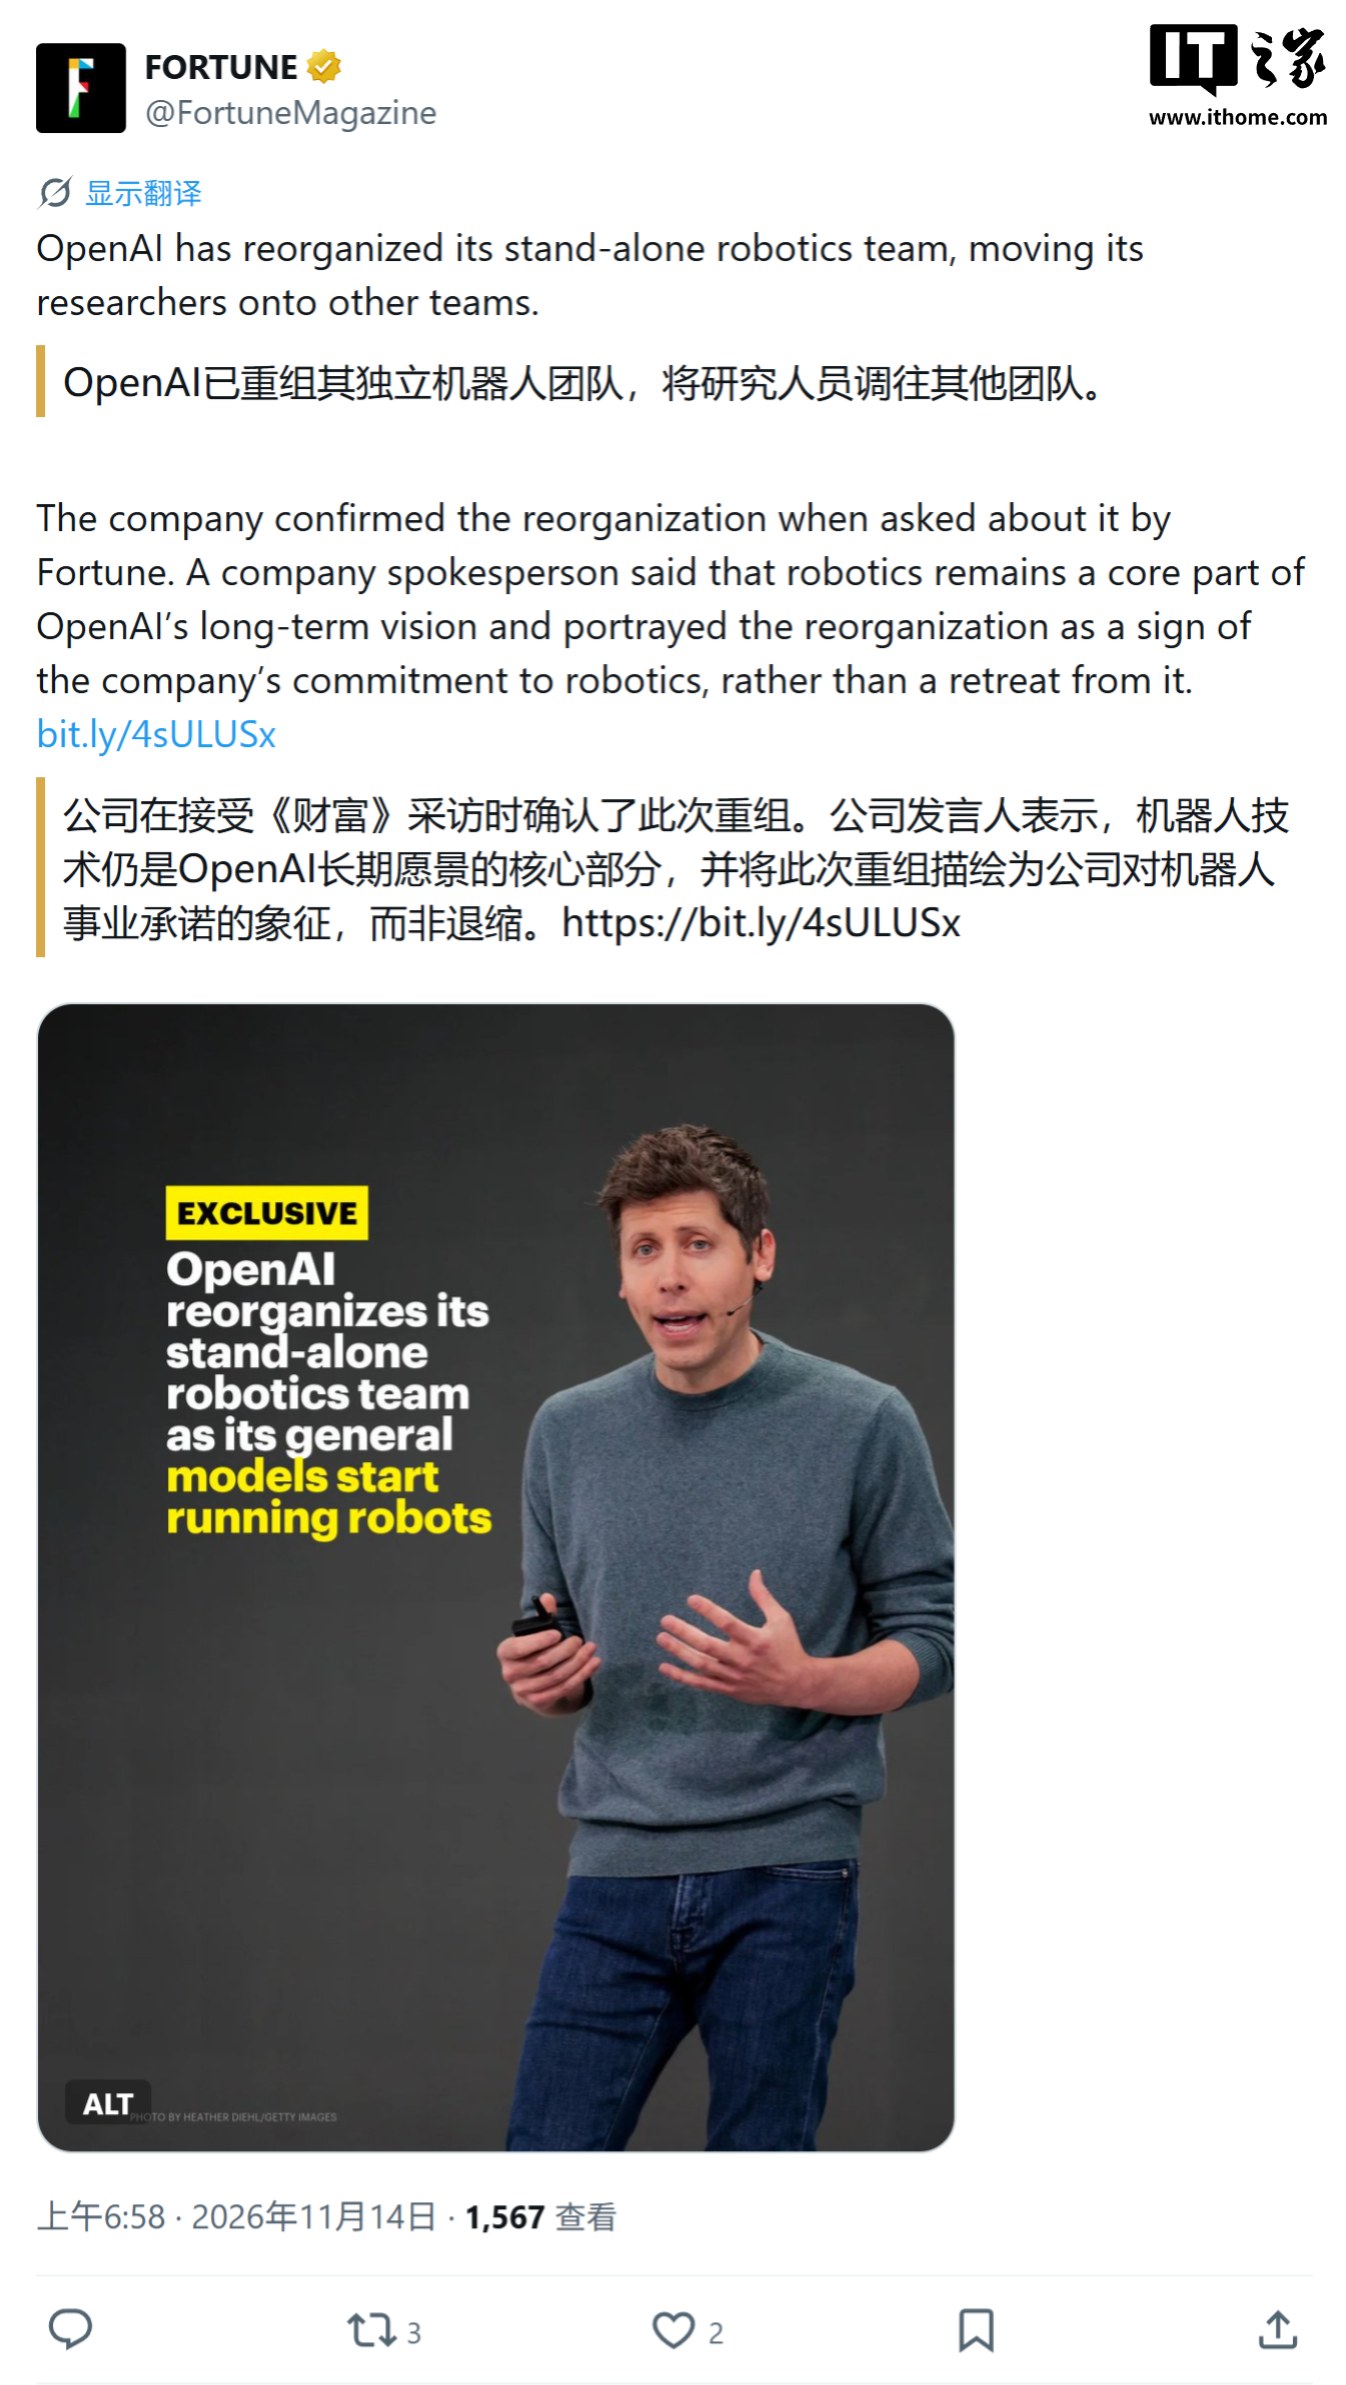
OpenAI 确认重组具身智能团队,机器人研究并入核心研究,硬件团队转入应用部门。官方的理由很直…

文章目录
一家公司解散一个团队,通常被解读为撤退。但 OpenAI 这次给出的说法正好相反:不是不做机器人,而是不再需要一支「专门为机器人造模型」的队伍。它想把通用大模型直接塞进机器人的脑袋里。
一分钟速览
- 调整内容:OpenAI 解散独立机器人团队,相关人员分流到核心研究与应用部门。
- 汇报关系:机器人研究人员向首席研究官马克·陈汇报,应用机器人与硬件团队转入格雷格·布罗克曼负责的应用部门。
- 官方理由:包括 GPT-6 Astra 在内的通用模型,已能直接承担部分机器人任务。
- 关键数据:英伟达一项研究显示,Astra 驱动的智能体在模拟操作测试中成功率 74.8%,高于专用模型领先者的 51.0%。
- 长期目标:自研人形机器人计划 2027 年首次公开演示。
「通用大脑」的逻辑
传统机器人栈是分层的:感知一套模型,规划一套模型,控制再由专门策略接管。每一层都要为具体本体、具体任务做大量适配,换一台机器、换一个场景,往往就得重来。OpenAI 想验证的是另一条路——一个能理解文字、图像和代码的通用模型,是否可以跨过这些分层,直接输出动作决策。
74.8% 对 51.0% 这组数字,是这套叙事最有力的支撑。它来自英伟达的一项研究,测试的是模拟环境中的操作任务。需要说明的是,模拟成绩和真机落地之间还有不小距离,但方向足够清晰:通用模型在「看懂任务、拆解步骤、调用技能」上的泛化能力,正在弥补它在精度和实时性上的短板。
现实的三道坎
第一是速度。机器人控制要求毫秒级闭环,而云端大模型的往返延迟天然吃亏。把模型塞到端侧,又受算力和功耗限制。第二是可靠性。工业场景容错率极低,一次错误抓取可能意味着停线。第三是数据。机器人企业在现场积累的力控、标定和故障处理经验,并不是靠互联网文本就能补上的。
这也解释了为什么 OpenAI 没有把话说满。它强调机器人仍是长期愿景的核心,重组是为了加快研发,而不是退出。把研究并入核心团队,意味着机器人不再是独立业务线,而是通用模型的一个应用出口;把硬件转入应用部门,则更像是为未来的产品化留接口。
对行业的连带影响
如果通用模型真能成为机器人的「默认大脑」,产业链的权力结构会被改写。过去值钱的是本体、关节、力控和专用算法;未来可能变成「谁拥有最强的通用策略模型,谁就定义机器人能做什么」。这对做专用机器人模型的公司是压力,对做本体和硬件的公司则未必是坏事——大脑标准化之后,身体反而更容易规模化。
另一层影响在人才。机器人团队被拆分,短期内会让一批具身智能研究者流向创业公司或竞争对手。而 2027 年的人形机器人演示目标,又给了外界一个明确的观察窗口:通用模型到底能不能在真实世界里站稳。
趋势洞察
这次调整最值得记住的,不是「OpenAI 不做机器人了」这种误读,而是它对技术路线的判断:具身智能的瓶颈,正在从「专门的机器人模型」转向「通用模型的实时性与可靠性」。谁能先把这两件事解决,谁就能把大模型的战场从屏幕延伸到物理世界。
本文地址:https://www.163264.com/21040