两台机器人隔墙配合拿笔:成功率从 0 到 100%,通信量还砍掉八成
星尘智能发布多机协同框架 CoMind,让机器人只交换任务关键信息,而不是互传整路视频。隔墙拿笔…

文章目录
让两台机器人一起干活,最容易出问题的不是手,而是「看不见」。一台刚抓住桌角,另一台已经开始抬;一方视线被挡,连队友做到哪一步都不知道。过去常见的解法是加一个中央调度器,或者干脆把摄像头画面全传给队友——前者慢半拍,后者把通信带宽烧穿。星尘智能给出的第三种答案,是让机器人学会「只说有用的那句」。
一分钟速览
- 发布方:深圳具身智能公司星尘智能(Astribot),框架名为 CoMind,副标题 Be My Eye。
- 核心机制:去中心化的主动信息共享,加上任务关键信息的精选与压缩。
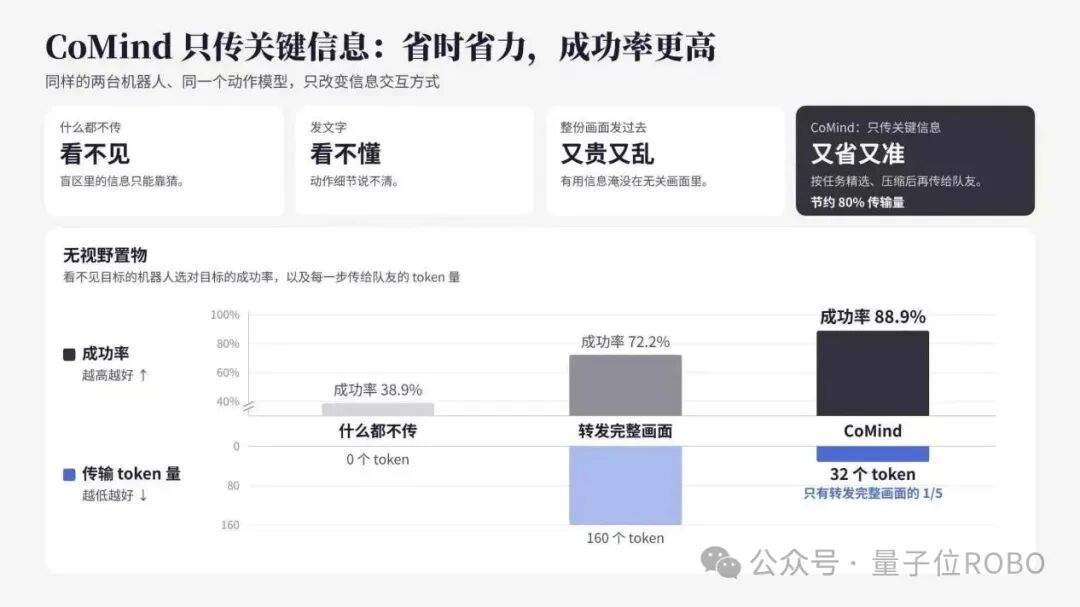
- 关键结果:两台机器人隔挡板配合拿笔,成功率从 0% 提升到 100%;盲盒置物准确率从 38.9% 提升到 88.9%,通信量减少约 80%。
- 真机任务:隔墙拿笔、盲盒置物、纸箱组装、叠被收纳、冰箱补货、哑铃组装六项。
不传画面,传「你现在需要知道什么」
CoMind 的技术路径分两段。第一段是上下文编码器:从多路摄像头观测里筛选、压缩出对当前任务真正有用的视觉特征和操作状态。第二段把这些信息与接收方自己的视觉、指令、本体状态一起送进视觉—语言—动作模型,直接生成连续动作。
关键设计在于训练时的误差回传。如果 A 最终伸错了位置,动作预测的误差会反向传到 B 的信息编码器,逼着它调整「该提取什么」。于是机器人之间的通信目标变了:不再是尽量准确地描述环境,而是让队友的动作决策更准。这也是它能把通信量压掉八成的根本原因——无关的家具、墙面、背景,本来就不该出现在消息里。
为什么这件事不容易
多机器人协作的难点,从来不是单机能力叠加。两台机器人分别会搬、会抓、会折,不代表合起来就能叠好一床被子。被子柔软易形变,提起、翻折、搬动时形状和受力一直在变,双方必须根据队友的实时状态调整自己。纸箱组装同理,翻转时会遮挡视线,谁也不知道对方抓到了哪个角。
学界也在找答案。斯坦福团队 2026 年提出的 CHORUS,让不同机器人共享同一套 VLA 策略,在各自独立感知的条件下形成默契;2026 年 10 月公开的 DuoMind,则用视觉语言模型做高层推理、VLA 做底层执行,探索分布式协同。CoMind 的切入点更靠近动作层:它关心的不是「如何形成共识」,而是「共享的信息能不能直接改善队友的下一步动作」。
一家绳驱机器人公司的路线选择
星尘智能成立于 2022 年底,创始人兼 CEO 来杰曾是腾讯 Robotics X 实验室架构师,也负责过百度小度机器人的研发。公司走的是相对少见的绳驱路线,推出过 Astribot S1、T1,并围绕模型、具身操作系统和本体做软硬件一体。今年 7 月的 Lumo-2 已经展示过人机协同与多机协作,CoMind 则把研究推进到机器人之间的信息交换层。
趋势洞察
具身智能的下一段竞争,可能不在「单台机器人有多能干」,而在「一群机器人能不能像班组一样配合」。工厂装配、仓储搬运、家庭服务,这些场景里没有哪台机器人能始终拥有完整视野。谁能让分散的视角高效流动,谁就更接近真实落地。CoMind 给出的数字未必是终局,但它把一个问题摆上了台面:协作的瓶颈,也许不是智能,而是沟通的效率。
本文地址:https://www.163264.com/21043