模型框架 编辑推荐
llama.cpp 终于到 1.0:150 多种模型架构,断网也能跑大模型
开源推理引擎 llama.cpp 与 ggml 一起进入 1.0.0,版本规则、模型支持和测试体…

文章目录
11 月 13 日,llama.cpp 的创建者 Georgi Gerganov 在社交平台宣布,这个开源推理项目和它底层的 ggml 引擎一起进入了 1.0.0 版本。
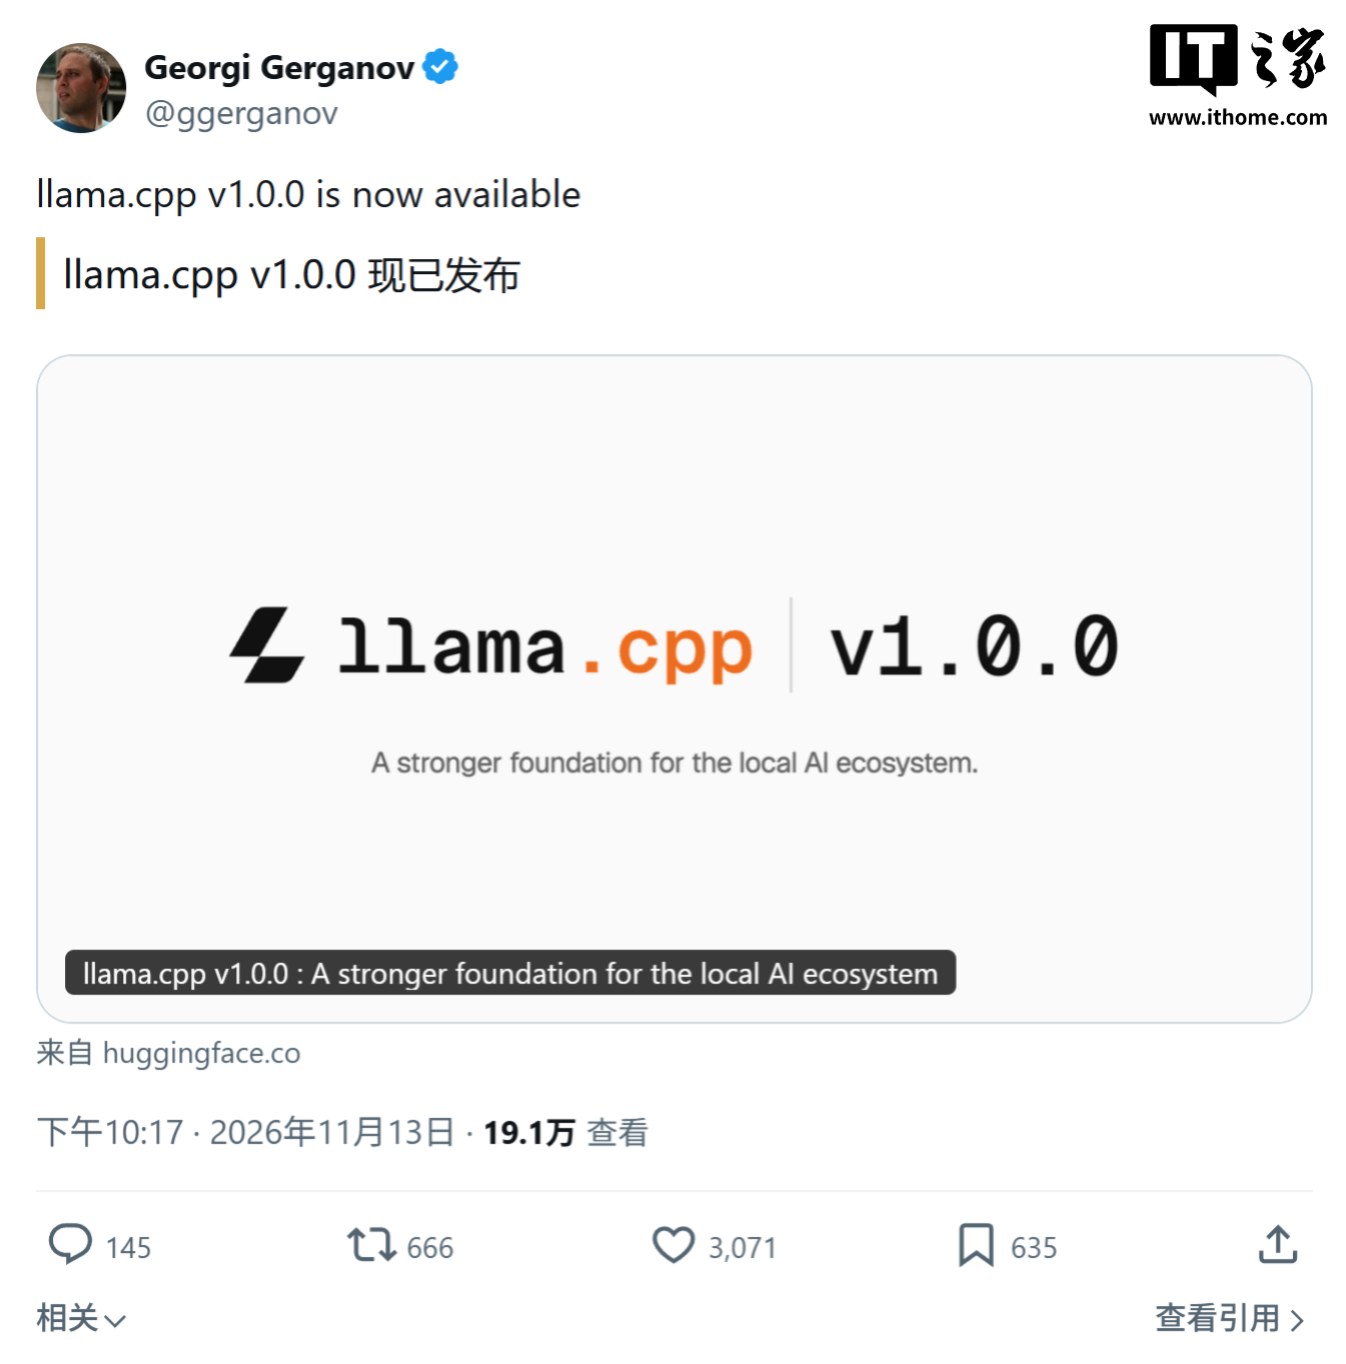
llama.cpp 主要用 C/C++ 写成,做的事情很直接:让大模型能在普通电脑、服务器等各类硬件上跑起来。它既能本地部署,也能放到云端,目标是把部署门槛降下来,同时把设备的算力榨干。
1.0.0 最大的变化不是某个新功能,而是把版本规则说清楚了。libllama 和 libggml 以后都按主版本号管理:主版本升级代表公共 C 接口有不兼容改动,次版本升级是向后兼容的新功能、新后端、新模型支持,修订号则只修 bug、不动接口。开发者看版本号就能判断升级会不会逼着自己改代码。
能力上,llama.cpp 现在已经支持超过 150 种模型架构变体,以及主流的推测解码方法。ggml 的后端可以编译成动态库,运行时按需加载,不同硬件走各自的专用路径。
为了跟上开发节奏,团队把持续集成也扩了:用 Hugging Face 的 Buckets 和 Jobs 撑起 CI,并在英伟达、AMD、高通、Arm、IBM、英特尔的硬件支持下增加自托管测试机,覆盖更多平台。
团队还特意提到,开发流程里会审慎使用大模型写代码,代码质量、架构控制和对实现细节的理解仍然放在第一位。对普通用户来说,最实际的意义是:断网、没有显卡加速的环境,也能把模型完整跑起来。
本文地址:https://www.163264.com/21127