大模型 编辑推荐
清华发布单细胞蛋白组模型 ProtCell:3.8 亿个细胞,跑在国产智算卡上
ProtCell 用 98 个公开数据集预训练,并在摩尔线程 S5000 上完成全流程复现,指标…

文章目录
清华大学自动化系江瑞课题组近日发布面向单细胞蛋白组的基础模型 ProtCell,论文也同步公开。
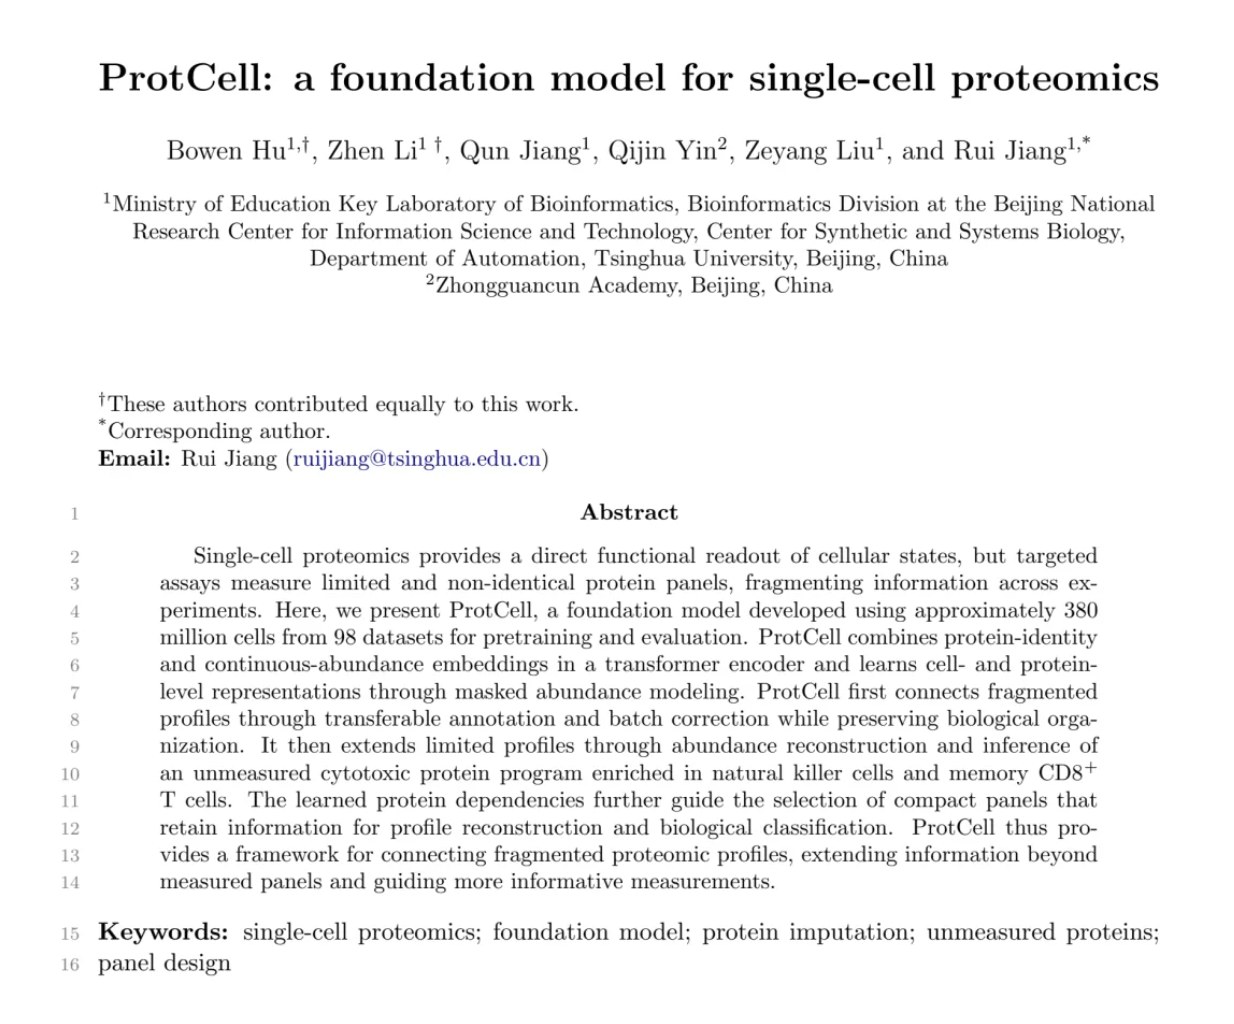
这个模型用了约 3.8 亿个细胞、98 个公开数据集做预训练和评估,能精准映射细胞状态、推断没测到的蛋白表达。说白了,就是给药物研发和“虚拟细胞”打底座:先在计算机里建出细胞的运行模型,再预测细胞被药物或基因编辑干预后会怎么变。
更值得注意的是算力这一环。团队在摩尔线程的 MTT S5000 智算卡上完成了 ProtCell 的全流程预训练复现,主要定量评测指标和国际主流 GPU 平台的差距只有约 0.2%。这说明国产全功能 GPU 加 MUSA 软件栈,已经能扛住前沿生命科学基础模型的训练。
“虚拟细胞”如今是 AI for Science 竞争的核心地带,国外顶尖机构和科技巨头正砸下数十亿美元和万卡集群。国内层面,《国务院关于深入实施“人工智能 +”行动的意见》把“人工智能 +”科学技术列在重点行动首位。而基因组、蛋白组这类数据涉及国家生物遗传资源安全,算力基座自主可控就成了绕不开的前提。
本文地址:https://www.163264.com/21136