7530 亿参数的 GLM-5.3,两台 DGX 跑出 607.8 tok/s:本地推理摸到“可服务”门槛
GLM-5.3 量化后约 464GB,单张 GB300 的 252GB HBM3e 装不下。NV…

文章目录
前沿模型的参数规模,正在把“本地部署”逼到一个尴尬的位置:单机装不下,云端又贵。NVIDIA 开发者博客给出了一个折中答案——用两台 DGX Station 通过 ConnectX-8 RDMA 互联,以张量并行方式服务 GLM-5.3,对外只暴露一个 OpenAI 兼容端点。测试结果不算惊艳,但足够说明问题:本地推理开始摸到“可服务”的门槛。
一分钟速览
- GLM-5.3 是量化后的混合专家模型,总参数 7530 亿,每 token 激活约 400 亿。
- 权重约 464GB,超过单张 GB300 GPU 的 252GB HBM3e,必须跨机存放。
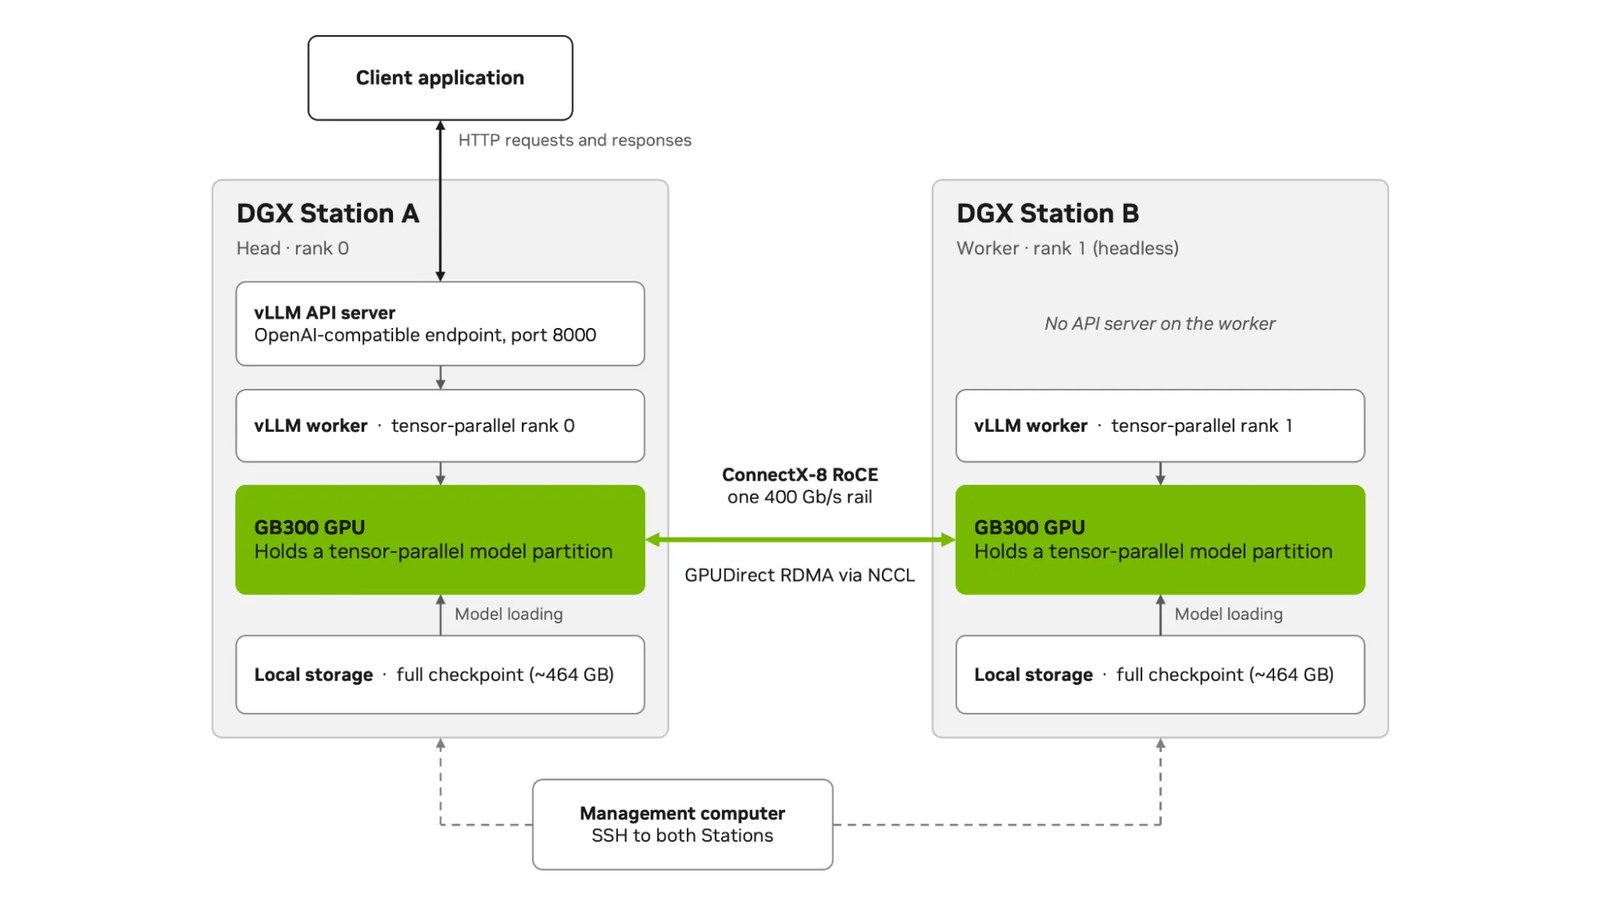
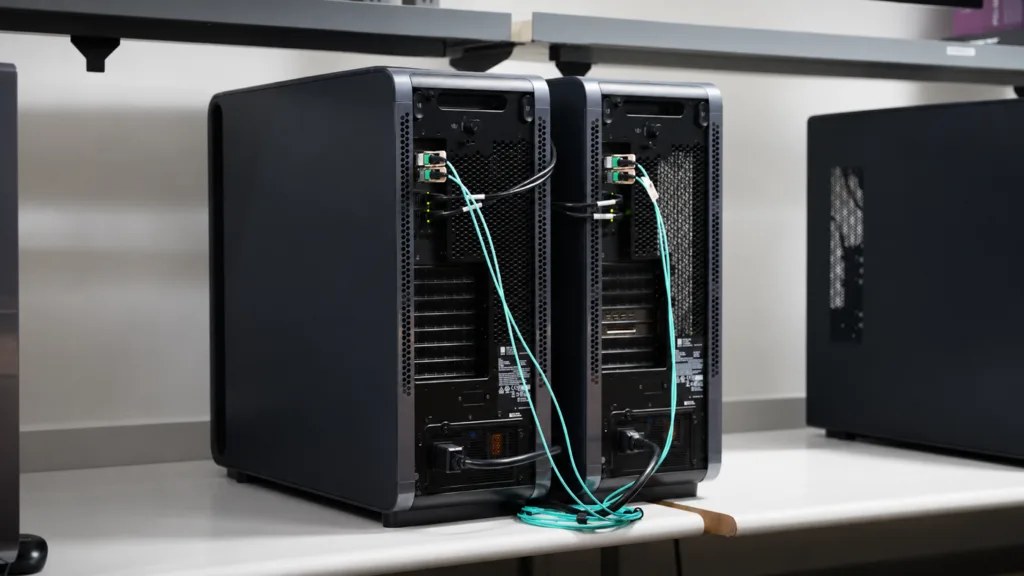
- 两台 DGX Station 走 ConnectX-8 RDMA,采用 TP=2,每张 GPU 持有并计算约一半权重。
- vLLM 启用多 token 预测、FP8 KV 缓存和前缀缓存,以提升并发吞吐。
- AIPerf 在 SPEED-Bench Coding 数据集上测得:并发 16 时输出吞吐峰值 607.8 tok/s;并发 32 时降至 385.0 tok/s,平均请求延迟 453.5 秒。
为什么单卡装不下
MoE 的稀疏激活容易让人误判显存需求。GLM-5.3 每个 token 只激活约 400 亿参数,计算量确实比同等总参数的稠密模型低得多;但所有专家权重都必须常驻可用,因为每个 token 可能被路由到不同专家。于是 7530 亿参数换算下来约 464GB,单张 GB300 的 252GB HBM3e 根本放不下。
NVIDIA 的方案是不做 CPU 权重卸载,而是让两台机器的 GPU 各自持有一半权重,通过 RDMA 互联做张量并行。两台 Station 都参与每个请求的计算,由其中一台通过单一 OpenAI 兼容 API 返回结果。对上层应用来说,这就像一个普通的推理端点。
607.8 tok/s 是什么水平
把数字放回场景里看:并发 16 时,输出吞吐峰值 607.8 tok/s,意味着在代码生成这类输出较长的任务上,系统能同时支撑十几个会话流畅出字。并发继续加到 32,吞吐反而降到 385.0 tok/s,平均请求延迟拉长到 453.5 秒——这说明瓶颈已经从算力转向调度与显存带宽,继续堆并发只会让每个用户等更久。
这类曲线的实践意义大于峰值本身:它告诉运维团队,这套配置的“甜点区”在并发 16 附近,超过之后应该加机器,而不是继续加队列。
几个值得注意的工程细节
第一,FP8 KV 缓存。长上下文场景下,KV 缓存会迅速吃掉显存;用 FP8 存储能在精度损失可控的前提下显著提高可服务的并发数。第二,前缀缓存。代码补全和智能体调用往往共享大段系统提示词,前缀缓存能把重复计算省掉,对吞吐的提升非常直接。第三,多 token 预测。它让模型一次前向产出多个 token,在输出密集的任务上收益明显。
还有一个容易被忽略的点:整套方案禁用了 CPU 权重卸载。这既是性能选择,也是体验选择——一旦权重落到内存,首 token 延迟会变得不可预测,对交互式应用是致命的。
对谁有意义
对大多数团队,这套配置仍然昂贵,它更像是“数据不能出机房”场景的解法:金融、医疗、政务,或者需要在本地做智能体编排、又不想把提示词和上下文发到云端的公司。对模型厂商,这是一份可复现的部署基线;对基础设施团队,这是一张“多大模型需要多少机器”的对照表。
更长期的信号是:MoE 把“总参数”和“激活参数”拆开之后,本地部署的门槛不再由模型能力单独决定,而由显存容量、互联带宽和缓存策略共同决定。谁能把这几个变量调平,谁就能把前沿模型塞进自己的机房。
下一步盯什么
一是更高并发下的调度优化,比如专家并行与请求分流的组合;二是 FP8 之外更低比特 KV 缓存的精度表现;三是单机多卡与多机互联的成本交叉点——当一台 8 卡机器的显存超过两台 Station 时,架构选择会再次改变。
607.8 tok/s 不是一个终点,而是一条基准线。它证明了两台机器也能服务一个 7530 亿参数的模型;接下来要证明的,是这套方案能不能在真实业务的长尾请求里保持稳定。
本文地址:https://www.163264.com/21225