微软 Maia 200 投产:3nm、216GB HBM3e,每瓦 token 性能提升 1.7 倍
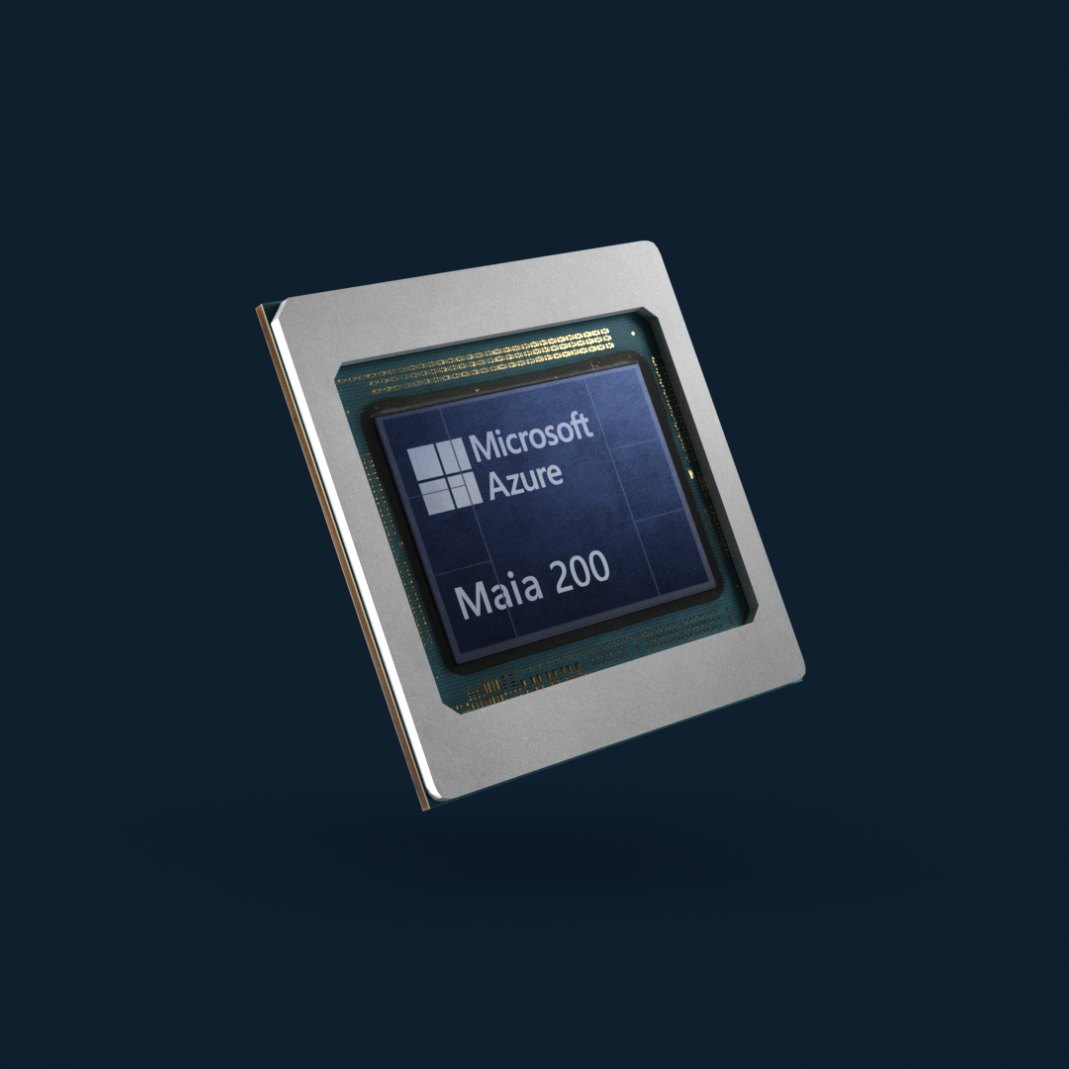
微软第二代自研 AI 加速器 Maia 200 已进入规模化生产,采用台积电 3nm 工艺,单芯…

文章目录
自研芯片这件事,微软已经讲了好几年。真正的分水岭不是“流片成功”,而是“敢不敢把生产流量放上去”。Maia 200 这次的关键词是“规模化生产”:它不再只是实验室里的样片,而是开始在数据中心运行微软最大规模的前沿 AI 模型。
一分钟速览
- Maia 200 采用台积电 3nm 工艺,配备 FP4 与 FP8 张量核心、216GB HBM3e 内存和 272MB 片上 SRAM。
- 单颗芯片在 FP4 精度下可提供超过 10 petaFLOPS 算力,可通过以太网扩展到最多 6144 颗加速器组成的集群。
- 在 Teams、Copilot、Cowork 等内置 AI 功能中,每瓦 token 处理量最高比“领先 GPU 基础设施”提升 1.7 倍。
- 已部署于美国、欧洲和澳大利亚,后续将支持 GitHub Copilot 与 Microsoft Foundry。
- 微软计划 2027 年把 Azure Maia 系统扩展到多吉瓦级部署,使其成为主要推理基础设施。
参数不是全部,但这次参数很具体
Maia 200 面向 AI 推理设计,而不是训练。3nm 工艺、FP4/FP8 张量核心、216GB HBM3e、272MB 片上 SRAM,这些配置指向一个很明确的目标:把大模型推理中最吃带宽、最吃缓存的环节尽量留在芯片内部,减少来回搬数据的开销。单芯片 FP4 超过 10 petaFLOPS,并通过以太网扩展到 6144 颗加速器的集群,说明微软想解决的不只是单卡性能,还有大规模推理时的互联与调度。
“每瓦 token 性能提升 1.7 倍”是这次最值得注意的指标。对云厂商来说,AI 推理的边际成本主要由电费、散热和机架密度决定;同样的电力预算能多产出 70% 的 token,等于直接改写单位经济模型。微软把它放在 Teams、Copilot、Cowork 这些已经大规模商用的功能里对比,而不是拿实验室 benchmark 说事,可信度相对更高。
为什么微软一定要做推理芯片
训练芯片拼的是峰值算力和互联,推理芯片拼的是成本、延迟和能效。微软的 AI 产品线——Copilot、GitHub Copilot、Dynamics、Security——几乎都是高频推理场景,调用量大、单次利润薄,对 GPU 价格极其敏感。把一部分推理负载迁到自研芯片上,一方面能压低成本,另一方面也能在与芯片供应商的谈判中多一张牌。
更重要的是供应安全。过去两年,AI 算力的瓶颈从“买不到 GPU”逐渐变成“买到了也未必能按时上架”。自研芯片意味着微软可以把产品路线图和晶圆产能绑在一起,而不是完全跟着外部供应商的节奏走。
部署节奏与影响
Maia 200 已部署在美国、欧洲和澳大利亚,服务 Copilot 等生产工作负载,并逐步支持 GitHub Copilot 与 Microsoft Foundry。2027 年扩展到多吉瓦级部署,是一个很有野心的目标:它意味着 Maia 不再只是“补充”,而要成为微软产品与服务的主要推理基础设施。
这并不代表 GPU 会被替代。训练、微调、长上下文、多模态等场景仍然高度依赖通用 GPU;但在最标准化、最大量的推理环节,专用芯片的性价比优势会越来越明显。云厂商的竞争,正在从“谁有更多 GPU”变成“谁能把每一瓦电变成更多可售 token”。Maia 200 是微软交出的第一份规模化答卷。
本文地址:https://www.163264.com/21698