微软 Ignite 2026 甩出 MAI 全家桶:决策、语音、安全、修图、编程五条线一起上
微软在 Ignite 2026 上一口气发布五款自研 MAI 模型,从企业决策、实时语音到网络安…

文章目录
如果只看一条发布,微软这次 Ignite 2026 像是在“补作业”;把五条发布放在一起看,它其实在搭一套自己的模型货架:企业要做判断,有 Decision;要接电话,有 Realtime;要查漏洞,有 Cyber;要改图,有 Image;要写代码,有 Code。每一条都不追求“全能”,而是把某一种高频任务拆出来,单独定价、单独优化。
一分钟速览
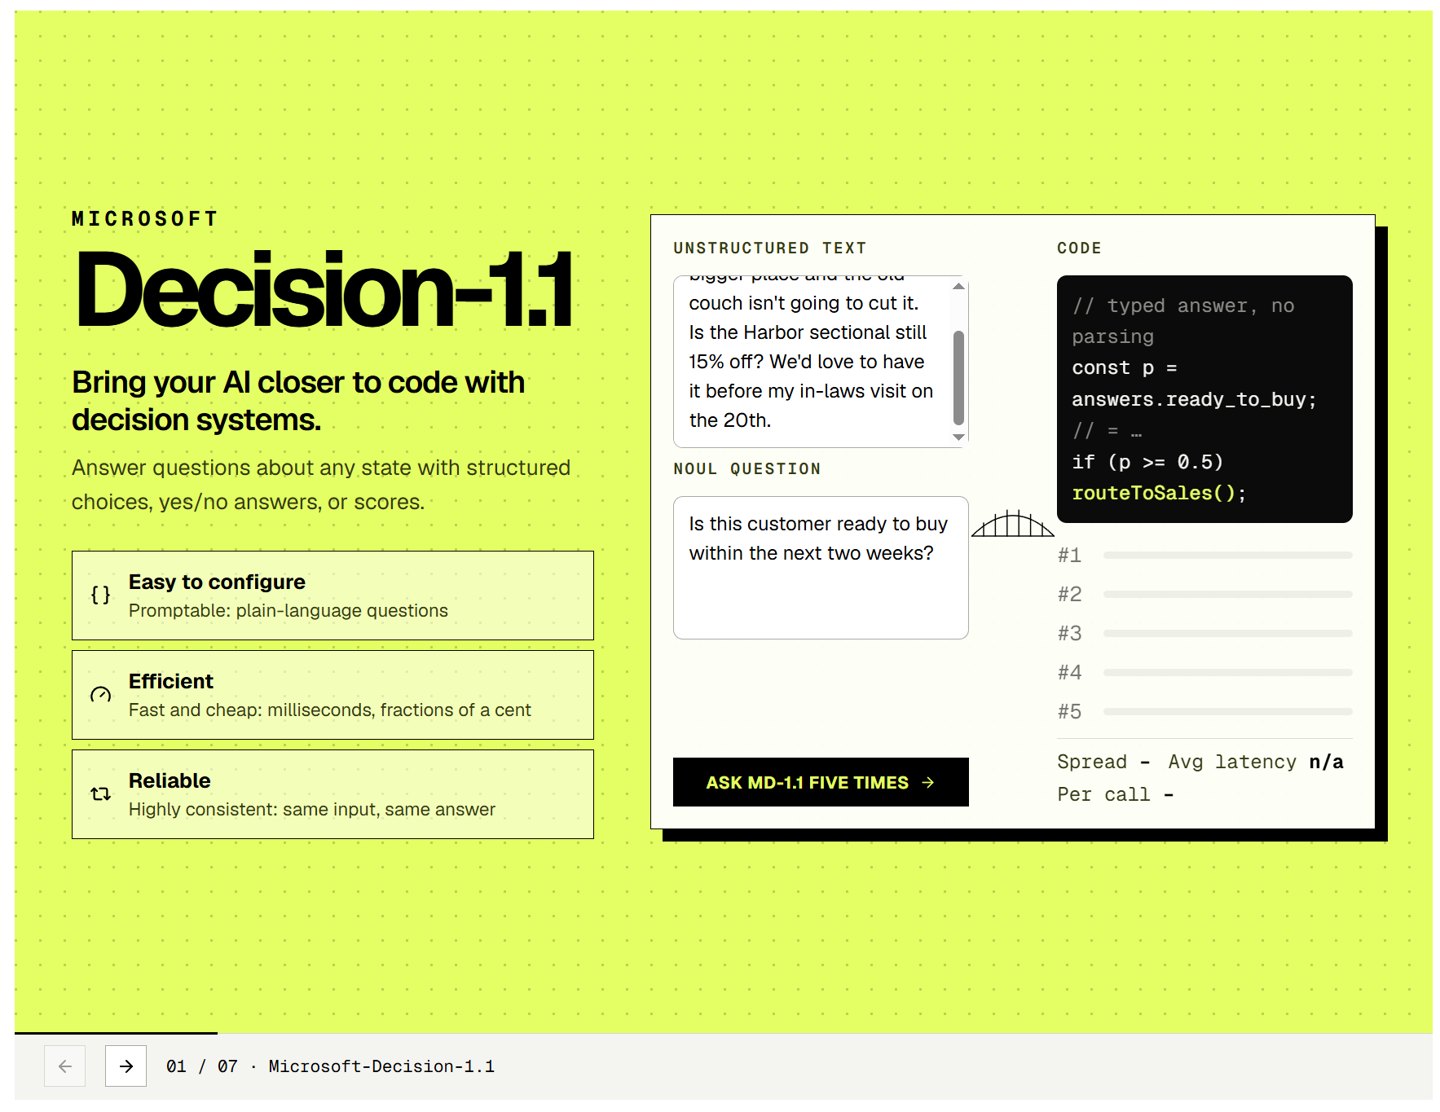
- Microsoft-Decision-1.1:面向路由、分类、优先级排序等决策场景,输入每百万 token 0.042 美元,输出免费。
- MAI Realtime 1:微软首款语音对语音模型,基础通话每分钟 0.01 美元,兼容 OpenAI Realtime API。
- MAI Cyber 2 Flash:CyberGym-E2E 任务成功率 92.3%,略高于 GPT-6 Astra 的 91.5%,单任务成本不到后者 2%。
- MAI Image 2.7:图像编辑榜 1215 分登顶,价格约为 GPT Image 2.6 的五分之一,支持透明背景。
- MAI Code 2:四项编程基准平均达到 GPT-6.1 Sol 约 98%,单次任务成本 0.309 美元,约为 Claude Opus 5.5 的 5%。
一、Decision-1.1:把“做决定”变成可按次计价的 API
Decision-1.1 最有意思的地方,不是它又拿了多少分,而是它承认自己“不该什么都答”。模型只在开发者设定的规则和允许的动作里做选择,同时输出校准后的置信度;信息不够时可以弃权,或者提示人工介入。这听起来不酷,但对路由、工单分流、内容核验、工作流控制这些企业高频动作来说,恰恰是刚需:业务要的不是一段漂亮的解释,而是一个可追责的选择。
价格也很有攻击性。全球标准版输入每百万 token 0.042 美元,输出免费;美国、欧盟和亚太数据区略有差异,最高 0.05 美元。微软称新版本速度比上一代快两倍以上,在 Artificial Analysis Decision Index v2.1 上得分 68,领先 Gemini Decision 1 和 GPT-6 Luna 的决策版本。它基于中型混合专家模型优化,可在 A100、H100/H200、GB200/300 等多种 GPU 上跑,显然就是冲着“量大、便宜、稳定”去的。
二、Realtime 1:语音不再只是转写,而是直接办事
MAI Realtime 1 是微软第一款语音对语音模型。它强调的不是“识别得多准”,而是能不能处理打断、快速确认、等对方说完这些真实对话细节;在嘈杂环境或多人同时说话时,也要能抓住用户意图。更关键的是,它可以在需要时调用更强的推理引擎,并连接企业系统完成预订、客服处理等操作。
定价是每分钟 0.01 美元,若涉及推理再按 token 另算。微软给出的对比很直接:Big Bench Audio 准确率 98.9%,每小时输入音频约 1.35 美元;GPT-Realtime-2 High 为 96.6%、每小时 4.14 美元;Grok Voice 2.0 为 97.2%、每小时 4.80 美元。它还兼容 OpenAI Realtime API,迁移成本被刻意压低。
三、Cyber 2 Flash:安全模型开始打“每任务成本”
安全模型的评测一向容易失真,微软这次把口径写得很细:在剔除 92 个与训练数据重叠的任务后,用剩余 813 个任务统计,Cyber 2 Flash 在 CyberGym-E2E 上达到 92.3% 的任务成功率,略高于 GPT-6 Astra 的 91.5%,而每任务成本不到后者 2%。另一项 WebExploitBench 中,它在相同推理预算下拿到 40.4%,高于 GPT-5.6 Cyber 的 38.4%。
100 万 token 的上下文窗口是上一代的四倍,意味着它可以一次性读进更大的代码库,做多步骤漏洞调查。需要说明的是,这些成本是离线评估口径,不等于客户实际账单;但对安全团队来说,“能不能全天候跑”往往比“单次多聪明”更重要。
四、Image 2.7:修图的关键是“只改该改的地方”
MAI Image 2.7 和 2.7 Flash 把重点放在局部编辑:改颜色、换材质、挪位置,同时保持画面其余部分稳定,并在连续修改中维持一致性。两款都支持透明背景,直接对准商品图、标志、图标和插画这些商业场景,减少后期抠图。
价格分别是每千张约 35 美元和 10 美元。微软称截至 11 月 16 日,MAI Image 2.7 在 Artificial Analysis 图像编辑榜以 1215 分位列第一,领先 GPT Image 2.6 Sunburst 4 分,成本约为后者五分之一。配套的 Canvas 把生成和修改放进同一个工作区,用户可以从文字或草图开始,再选中局部替换、移动或调风格。
五、Code 2:用 5% 的成本,换 96% 的性能
MAI Code 2 和 Code 2 Flash 已上线 GitHub Copilot。前者面向复杂软件开发,强调跨文件修改、整仓理解和 UI 开发;后者面向解释代码、定点修改、修常见问题这类高频轻量任务。两款都支持工具调用和分步骤推进。
微软给出的数字很有冲击力:Code 2 在四项编程基准平均达到 GPT-6.1 Sol 约 98%,价格约为其 40%;平均单次任务成本 0.309 美元,而 GPT-6.1 Sol 是 0.761 美元,Claude Opus 5.5 是 6.306 美元。Code 2 Flash 在促销价下单次任务低至 0.052 美元,DeepSWE 1.1、Terminal-Bench 2.1 和 SWE Atlas 三项平均通过率 61.0%,高于 GPT-6 Luna 的 55.1% 和 Claude Haiku 5.5 的 53.9%。
六、这套打法的真正意图
五款模型有一个共同点:不拼“最大”,拼“单位任务成本”。微软把模型切成决策、语音、安全、图像、编程五个货架,再用 Foundry、Copilot、GitHub、安全产品这些现成渠道铺出去。对企业客户来说,采购逻辑会从“买一个最强模型”变成“按任务买最划算的模型”;对模型厂商来说,价格战会从每百万 token,进一步打到每次任务、每分钟通话、每张图。
当然,微软公布的对比大多来自自家或特定配置,真实体验还要看负载、推理强度和评测方法。但方向已经很清楚:2026 年的企业 AI 竞争,正在从参数竞赛转向“谁能让 Agent 便宜地跑完一整条业务流程”。谁把这件事做成标准化商品,谁就更容易拿到规模。
本文地址:https://www.163264.com/21695