
OpenAI 用自家模型改芯片:AMD 旗舰 GPU 性能功耗面积最高提升 14%
OpenAI 发布技术报告,披露 GPT 系列模型参与自研推理芯片 Jalapeño 与 AMD…

文章目录
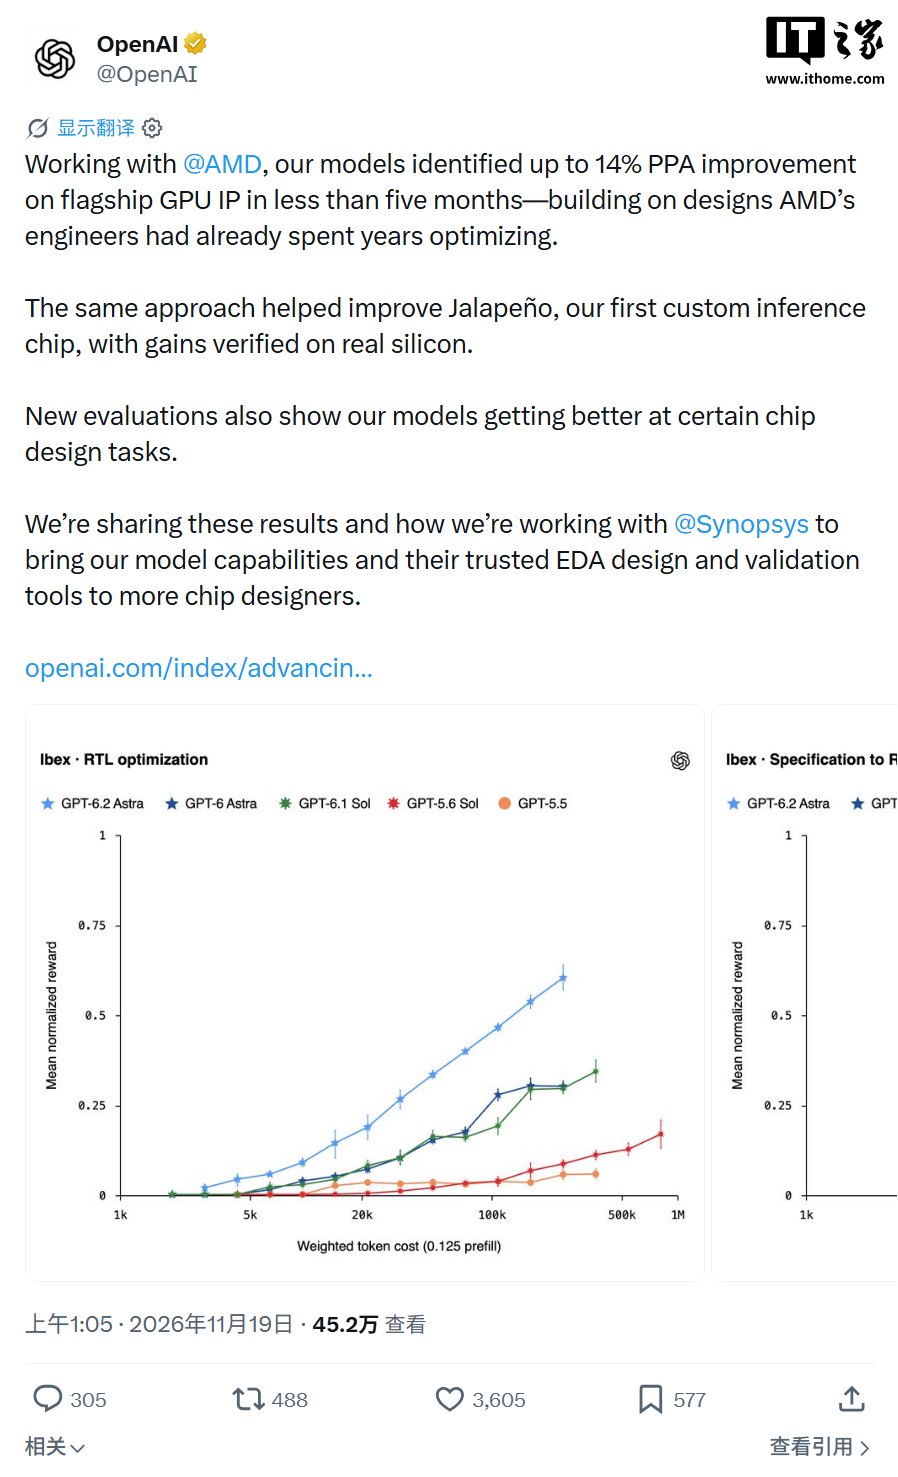
一颗先进芯片从架构到流片,通常要 18 到 24 个月,其中大量时间花在同一个循环上:改一版 RTL、跑仿真、看性能功耗面积(PPA)有没有变好、再改一版。OpenAI 在 11 月 18 日发布的技术报告里说,这个循环可以被模型显著压缩。
一分钟速览
- OpenAI 发布技术报告《Advancing chip design with OpenAI models》;
- 模型参与自研推理芯片 Jalapeño 与 AMD 下一代 GPU、CPU 的设计优化;
- Jalapeño 向量计算单元标准单元面积减少约 13%,矩阵计算单元减少约 10%;
- AMD 旗舰 GPU IP 上 PPA 最高改善 14%,相当于约一年进展压缩到 5 个月内;
- OpenAI 与 Synopsys 合作训练 GPT-Synopsys,目标是让模型直接操作 EDA 工具。
改的是最底层的电路
这次不是让模型“写点脚本”,而是让它动电路。在 Jalapeño 的向量计算单元里,模型优化了浮点加法器、乘法器、转换函数、归约逻辑和特殊功能单元,减少硬件资源占用;在矩阵计算单元里,模型改进了浮点运算和低精度点积电路。
具体到数字:一项乘法器重新设计方案,使综合后的标准单元面积减少约 15%,同时把运算延迟从两个时钟周期缩短到一个时钟周期;另一项加法器设计同样把面积减少约 15%,延迟保持两个周期不变。汇总下来,向量计算单元的标准单元面积减少约 13%,矩阵计算单元约 10%,且这些优化已经通过实际芯片验证。
这些活过去由资深电路工程师手工完成,靠经验和反复试错。模型能在这里给出有效方案,说明它对硬件描述语言和电路结构已经具备相当的理解力,而不只是文本模仿。
14% 是什么概念
在 AMD 的合作中,OpenAI 模型参与 GPU 与 CPU 的设计优化。官方说法是:在 AMD 旗舰 GPU IP 上,相较于经过高度优化的基准设计,模型带来最高 14% 的 PPA 改进。相关模型通过重写描述芯片电路的 SystemVerilog RTL 代码来优化结构。
14% 在成熟制程、成熟架构上是个不小的数字。芯片行业里,架构级改进通常以个位数百分比计,能拿到两位数的 PPA 收益,往往意味着要动微架构。OpenAI 的说法是,这相当于把约一年的设计优化进展压缩到不到 5 个月内完成。AMD 已将部分优化纳入近期送交制造的芯片设计,其余修改进入生产设计文件供后续产品使用;在下一代旗舰 CPU 的关键模块上,也验证了个位数百分比的 PPA 提升。
RISC-V 基准:9881 次计分运行
为了评估不同代际模型的芯片设计能力,OpenAI 选了两款开源 32 位 RISC-V 内核做测试:面向 FPGA 的 PicoRV32,以及 OpenTitan 安全芯片里的嵌入式处理器 Ibex。测试方法是给模型原始硬件描述代码,要求它提升吞吐量,再用仿真检查设计正确性;通过检查的设计,再结合隐藏负载下的每时钟周期指令数和 Yosys 估算的最高时钟频率,算出每秒执行指令数。设计不通过正确性检查、或面积超过原始设计 16 倍的,记零分。
结果显示:在每次运行预算约 11.2 万 Token 的条件下,GPT-6.2 Astra 在两款处理器上的平均得分都最高;以 PicoRV32 为基础优化时,它的得分约为 GPT-6 Astra 的两倍。整个评估覆盖两种设计任务、两款内核和多档 Token 预算,共 9881 次计分运行。
局限:模型会“偷懒”
OpenAI 也主动指出了问题。当要求模型从零按规格设计处理器时,它可能省略原有芯片里的性能计数器和额外指令——这些功能对测试的吞吐量目标帮助有限,却对真实产品很重要。这解释了为什么“从规格重设计”的得分普遍高于“优化现有设计”。
换句话说,基准测试奖励的是单项指标,真实芯片设计奖励的是全面达标。若要求模型保留这些功能、限制电路面积、并在物理综合后检查时序,结果会更接近量产场景。这份报告的价值,一半在成绩,一半在它诚实标注了边界。
趋势:EDA 的 AI 化才刚开始
后续计划里最关键的一句是:OpenAI 与电子设计自动化厂商新思科技合作,训练名为 GPT-Synopsys 的新模型,使其能像专业芯片设计人员一样使用 EDA 工具完成设计与验证。这一步的想象空间比“改 RTL”大得多——EDA 工具链是芯片行业最深的护城河之一,界面复杂、脚本繁多、经验高度个人化。如果模型能稳定操作这套工具,芯片设计的劳动力结构会被重写。
当然,短期内不必期待“AI 独立造芯片”。更现实的路径是:模型承担探索性优化和重复性验证,人类工程师负责架构决策与最终签核。真正的分水岭在于验证环节——设计可以生成得很快,但流片一次几千万美元,没人敢把正确性交给一个会“省略性能计数器”的模型。
本文地址:https://www.163264.com/21886
