地平线发布 LoFT:用双循环 Transformer 从视频里“拆”出三维世界
地平线机器人实验室发布原生视频几何基础模型 LoFT,可从 RGB 视频联合预测相机位姿、内参与…

文章目录
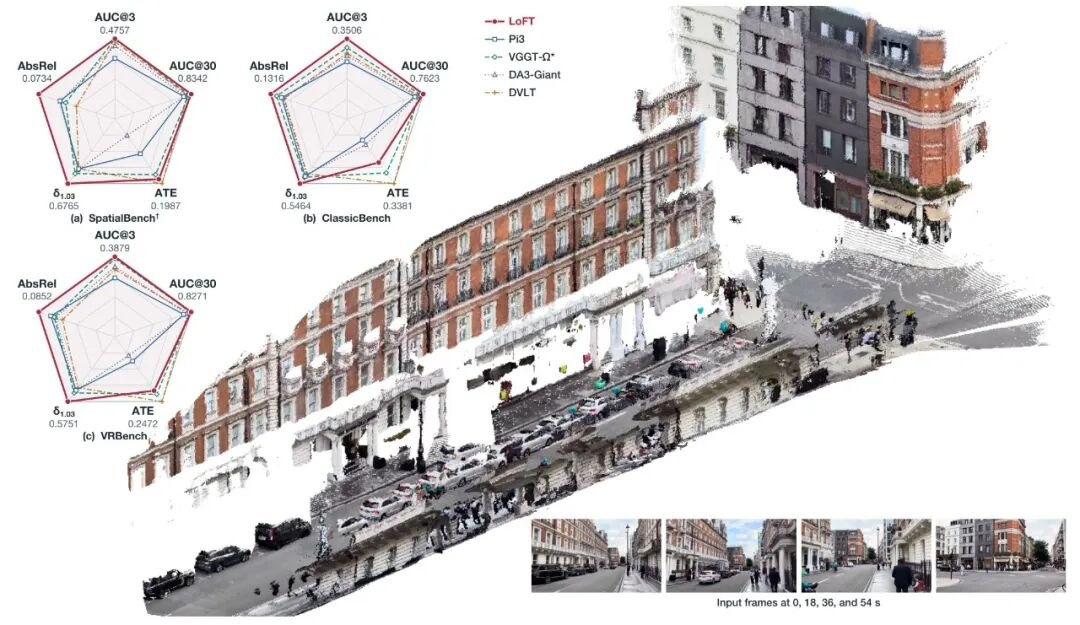
一台机器人走进堆满杂物的客厅,它需要在几百毫秒内判断:沙发离我多远,桌子腿在哪,摄像机现在朝向哪。这些判断的底层能力,行业里叫“视频几何”——从连续画面里恢复出三维结构。11 月 18 日,地平线机器人实验室发布了原生视频几何基础模型 LoFT,直接对准的正是这块地基。
一分钟速览
- LoFT 全称 Looped Foundation Transformer for Video Geometry,定位原生视频几何基础模型;
- 可从 RGB 视频联合预测相机位姿、相机内参与逐帧深度,恢复场景三维结构;
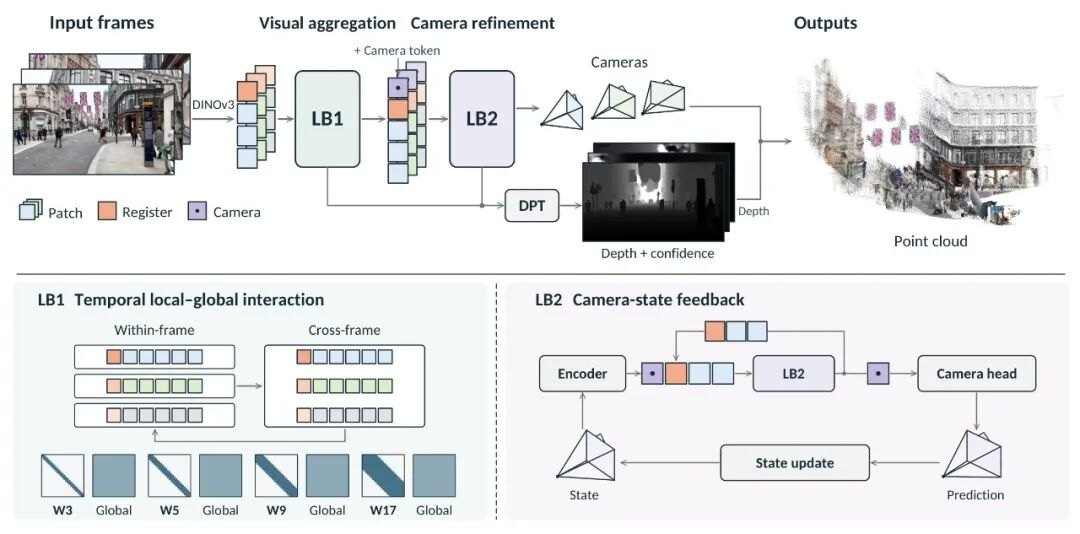
- 采用双循环 Transformer:一环聚合跨帧视觉信息,一环迭代优化相机状态并反馈;
- 训练数据约 297 万条有效序列、9.62 亿帧图像,覆盖仿真与真实、动态与静态场景;
- 在 SpatialBench、ClassicBench、VRBench 的深度估计指标上达到 SoTA。
视频几何难在哪
单张图片估计深度,本质是一个“猜”的问题,模型可以靠语义先验蒙个大概。视频不一样:它要求模型在多帧之间保持几何一致——这一帧的墙角,下一帧还得在同一个三维位置;相机往前走了半米,深度图必须跟着变,而不是各帧各猜各的。相机位姿、内参、深度三者互相耦合,任何一项估错,另外两项都会被带偏。
传统做法是流水线:先做特征匹配,再解本质矩阵,最后做稠密重建。每一步都有手工设计的假设,遇到动态物体、弱纹理墙面、快速运动就崩。端到端的几何基础模型想做的,是把这条流水线整个吞进网络里。
双循环:把“看”和“算相机”分开又咬合
LoFT 的架构叫双循环 Transformer。第一循环负责“看”:通过局部与全局时序注意力聚合跨帧信息,逐步扩大时间感受范围,既利用相邻帧的连续性,也利用跨视角的几何关联。第二循环负责“算”:显式更新相机位姿与内参,再把更新后的相机状态反馈到下一轮特征计算里。
这个设计的巧妙之处在于分工明确又不割裂。很多模型把位姿当成隐变量,让网络自己悟,结果可解释性差、误差会累积。LoFT 把相机状态显式建模,等于给网络装了一个“知道自己站在哪”的模块,每轮都校正一次。最后,模型结合双循环的特征预测逐帧深度及其置信度,恢复出场景的可见三维结构。
数据是另一半护城河
几何模型的成败,一半在架构,一半在数据。地平线为 LoFT 搭了统一的三维重建数据处理与训练平台,约 297 万条有效训练序列、9.62 亿帧图像记录,覆盖仿真与真实、动态与静态等多样化场景,并通过统一的数据清洗、质量筛选和采样策略保证数据底子。
这个量级值得注意。三维几何的真值标注极其昂贵,真实场景几乎不可能大规模采集;纯仿真数据又存在域差异。能凑出近三百万条有效序列,说明团队在数据合成、自动标注和筛选上做了大量工程。对后来者而言,这比模型结构更难复制。
评测:和 VGGT-Ω、DA3-Giant 正面比
研究团队在三套评测体系上做了对比。SpatialBench 覆盖 12 个数据集、98 个连续视频场景;ClassicBench 整合 7 个经典视频重建基准;VRBench 则覆盖机器人、自动驾驶及通用视频场景。对手包括 VGGT-Ω、DA3-Giant 等代表性模型。
官方公布的结果是:LoFT 在多项深度估计指标上达到 SoTA,在经典重建与连续视频重建两类任务中同样取得领先。需要客观看待的是,这些数据来自官方口径,完整的技术报告与第三方复现还没出来;几何模型的评测对场景分布非常敏感,真实机器人场景里的表现仍需实测。
从重建到具身:真正的落点在机器人
地平线的主业是机器人计算平台,LoFT 的落点也很清楚:机器人第一人称视频、动态街道、室内操作、开放环境探索。这些场景的共同点是“边动边看”——相机在移动,场景在变化,还有行人和车辆在动。能把动态物体和静态结构分开、能在运动中稳定估计位姿,才谈得上空间感知与环境理解。
再往上一层,是具身学习。机器人要学会“把杯子放进水槽”,先得知道杯子和水槽在三维空间的相对位置。几何基础模型提供的正是这层不含语义偏见的结构信息,它可以和视觉语言模型互补:一个负责“这是什么”,一个负责“它在哪里、有多大、离多远”。
趋势:世界模型的“几何地基”
今年行业谈世界模型,注意力多集中在生成侧:能不能生成逼真、可交互的视频和场景。但要让智能体真的在里面行动,光有像素不够,还得有可度量、可推理的三维结构。几何基础模型做的就是这件事——它不产出好看的内容,却决定了智能体能不能算准一步走出去多远。
从竞争格局看,这条路线上已经有 VGGT 系列、Depth Anything 系列等玩家。地平线以机器人为落点切入,优势在场景理解和硬件协同,挑战在生态与通用性。LoFT 能否成为具身智能的默认几何底座,接下来要看两件事:代码与权重是否开放,以及在真实机器人数据上的泛化表现。
本文地址:https://www.163264.com/21882