应用 编辑推荐
14MB 内存跑 2.7 亿参数模型:谷歌工程师让激光打印机自己算 AI
谷歌 DeepMind 技术团队成员奥马尔·圣塞维耶罗 11 月 17 日在 X 上发了一条推文…

文章目录
谷歌 DeepMind 技术团队成员奥马尔·圣塞维耶罗 11 月 17 日在 X 上发了一条推文,展示了一个相当离谱的实验:只用 14.1MB 内存,就让一台办公激光打印机跑起了 2.7 亿参数的 Gemma 3 270M 模型,代价是每输出一个词元大约要 60 秒。
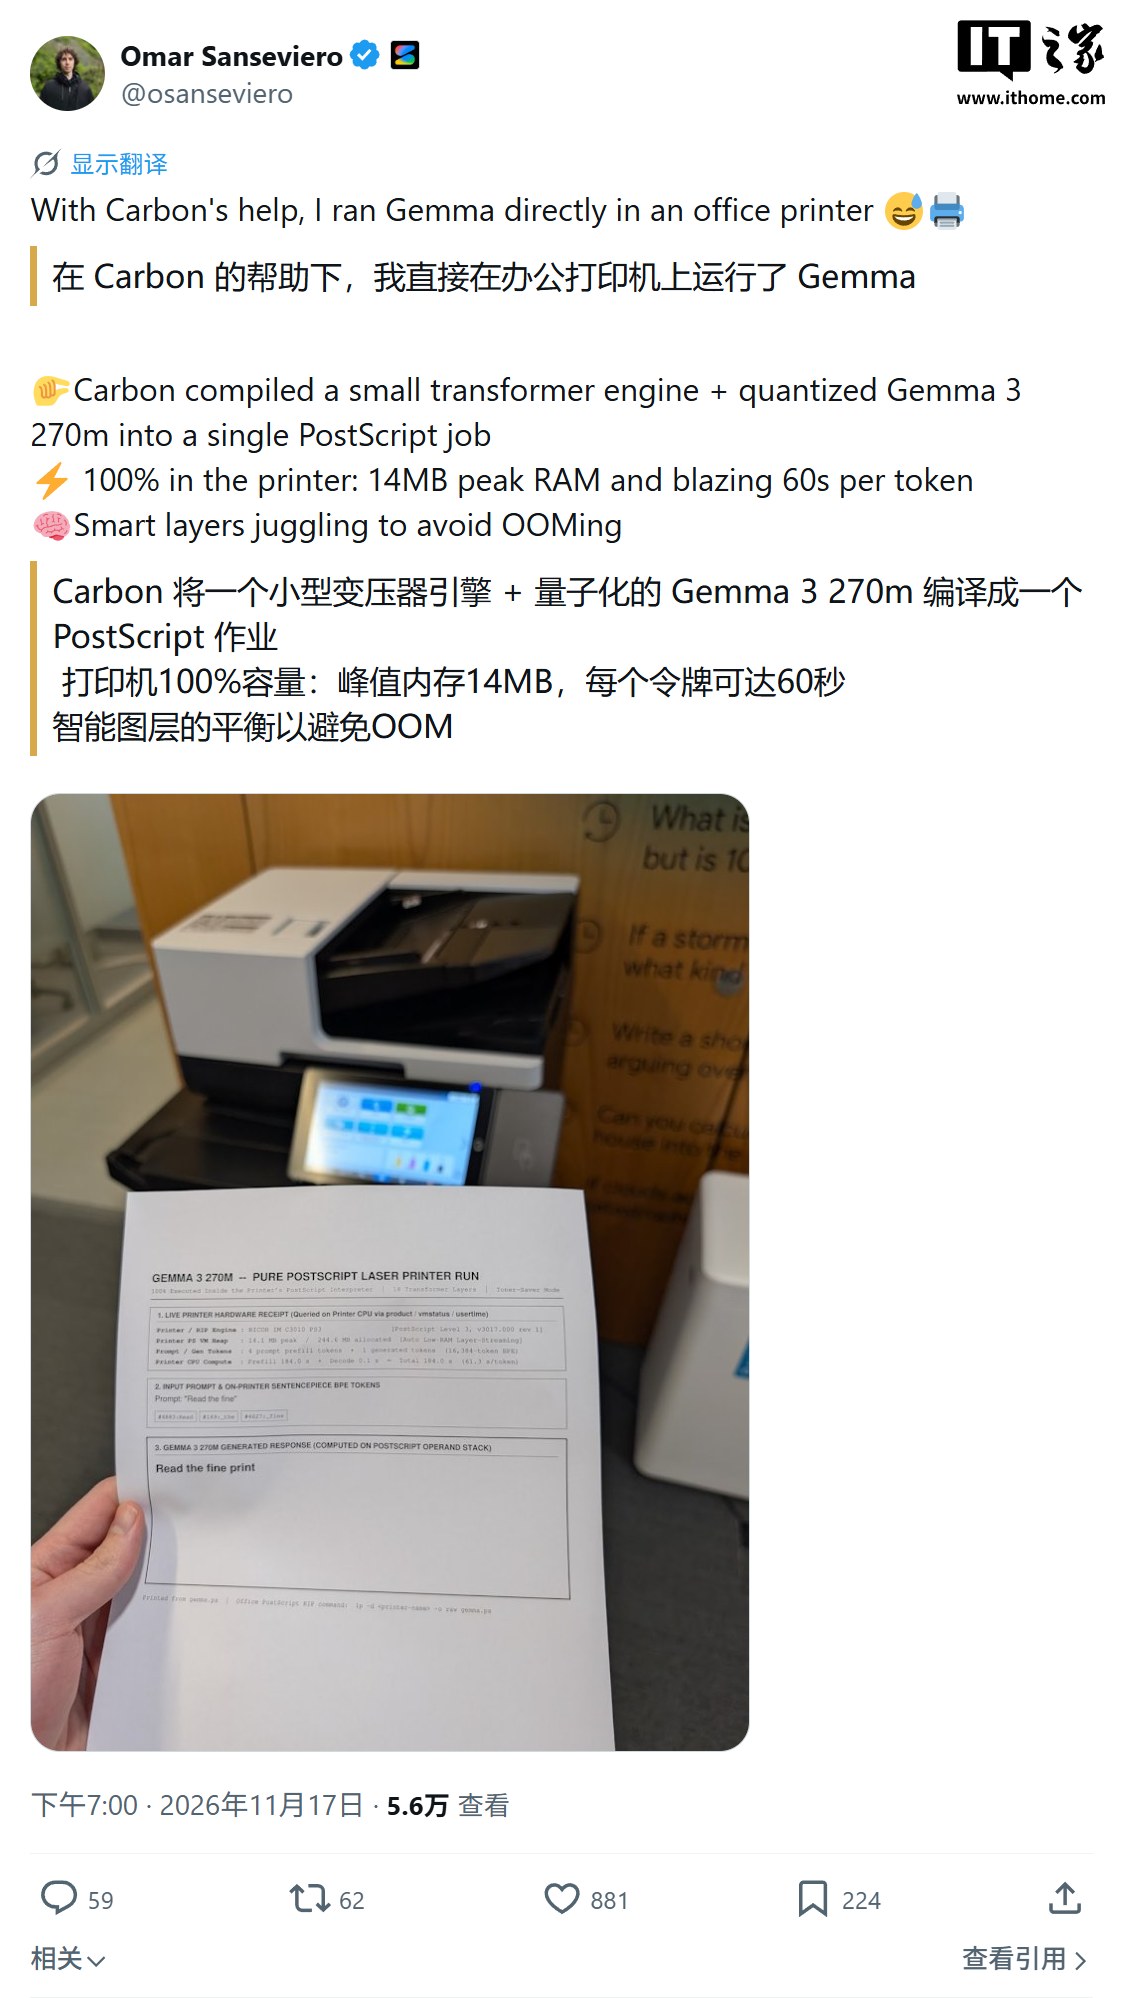
他的做法不是给打印机装电脑。整个实验没有改打印机固件,也没有加外部计算板,而是借助 Gemini 4 Carbon,把一个小型 Transformer 推理引擎和量化后的模型编译成一个 PostScript 打印任务。PostScript 本来是描述打印页面的语言,结果被拿来直接跑 AI,打印机内置的解释器就这么成了推理引擎。
内存不够怎么办?模型并不一次性装进去,而是采用动态层加载,轮流把各层调入、移出内存,运行时峰值占用约 14.1MB。整个推理涉及 18 个 Transformer 网络层。
速度方面得看清楚单位:是每个词元 60 秒,不是每秒 60 个词元。在预填充阶段,处理输入提示 Read the fine 花了约 184 秒,解码单个生成词元耗时 0.1 秒,总计 184.1 秒。算完的答案,最后由打印机打印出来。
这当然不是实用产品,更像一次极限压测:把模型塞进最不可能的地方,看看边界在哪。对端侧 AI 来说,这种”在垃圾硬件上也要跑”的思路,反倒是最实在的工程参考。
本文地址:https://www.163264.com/22192