OpenAI 公开“反蒸馏”防线:偷推理轨迹的成功率,从 54% 压到 0.2%
训练一个前沿模型要花几十亿美元,偷它的能力却可能只需要大量调用 API。这个不对称,是当下 AI…

文章目录
训练一个前沿模型要花几十亿美元,偷它的能力却可能只需要大量调用 API。这个不对称,是当下 AI 安全最现实的漏洞之一。11 月 20 日,OpenAI 罕见地公开了自己对付“对抗性蒸馏”的整套做法,并给出了一个相当硬核的数字:针对推理轨迹的提取攻击,成功率从 54.0% 降到了 0.2%。
先把概念说清楚。蒸馏本身是常规技术:让一个模型学习另一个模型的答案、推理过程或判断偏好。问题出在“未经授权”四个字——攻击者可以用前沿模型的输出,训练出一个能力相近、却没有同等安全护栏的模型,然后拿去干原模型会拒绝的事。
一分钟速览
- 对抗性蒸馏指未经授权复制前沿模型能力,并绕开其安全防护。
- OpenAI 重点保护“受保护的推理过程”,即模型的思维链。
- 在 GPT-6.2 Astra 与 GPT-6.2 Sol 上强化了防提取能力。
- 内部自适应红队测试中,平均攻击成功率从 54.0% 降至 0.2%。
- 防御组合包括对抗测试、模型训练、分类器、API 层保护与协同攻击调查。
为什么盯上“思维链”
OpenAI 在文章里解释得很直白:模型在给出最终答案之前,内部会生成一段中间推理,也就是思维链。这段轨迹往往包含最终答案里没有的信息——它怎么拆解问题、试过哪些路径、在哪里自我纠正。对另一个模型来说,这些是最有价值的训练数据。
换句话说,答案可以抄,过程更难抄;而过程恰恰是能力的关键。OpenAI 把保护推理轨迹放到了很高的优先级,理由不只是知识产权,更是安全:网络攻防和生物领域的“双重用途”能力,一旦被转移到护栏更弱的模型上,风险会成倍放大。
一个会帮防守方找漏洞的模型,同样能帮攻击方利用漏洞;一个能辅助生物研究的模型,也可能被用来设计有害病原体。原模型会拒绝的请求,蒸馏出来的模型未必会拒绝——这就是 OpenAI 所说的“能力被复制,护栏没被复制”。
54% 到 0.2%,是怎么做到的
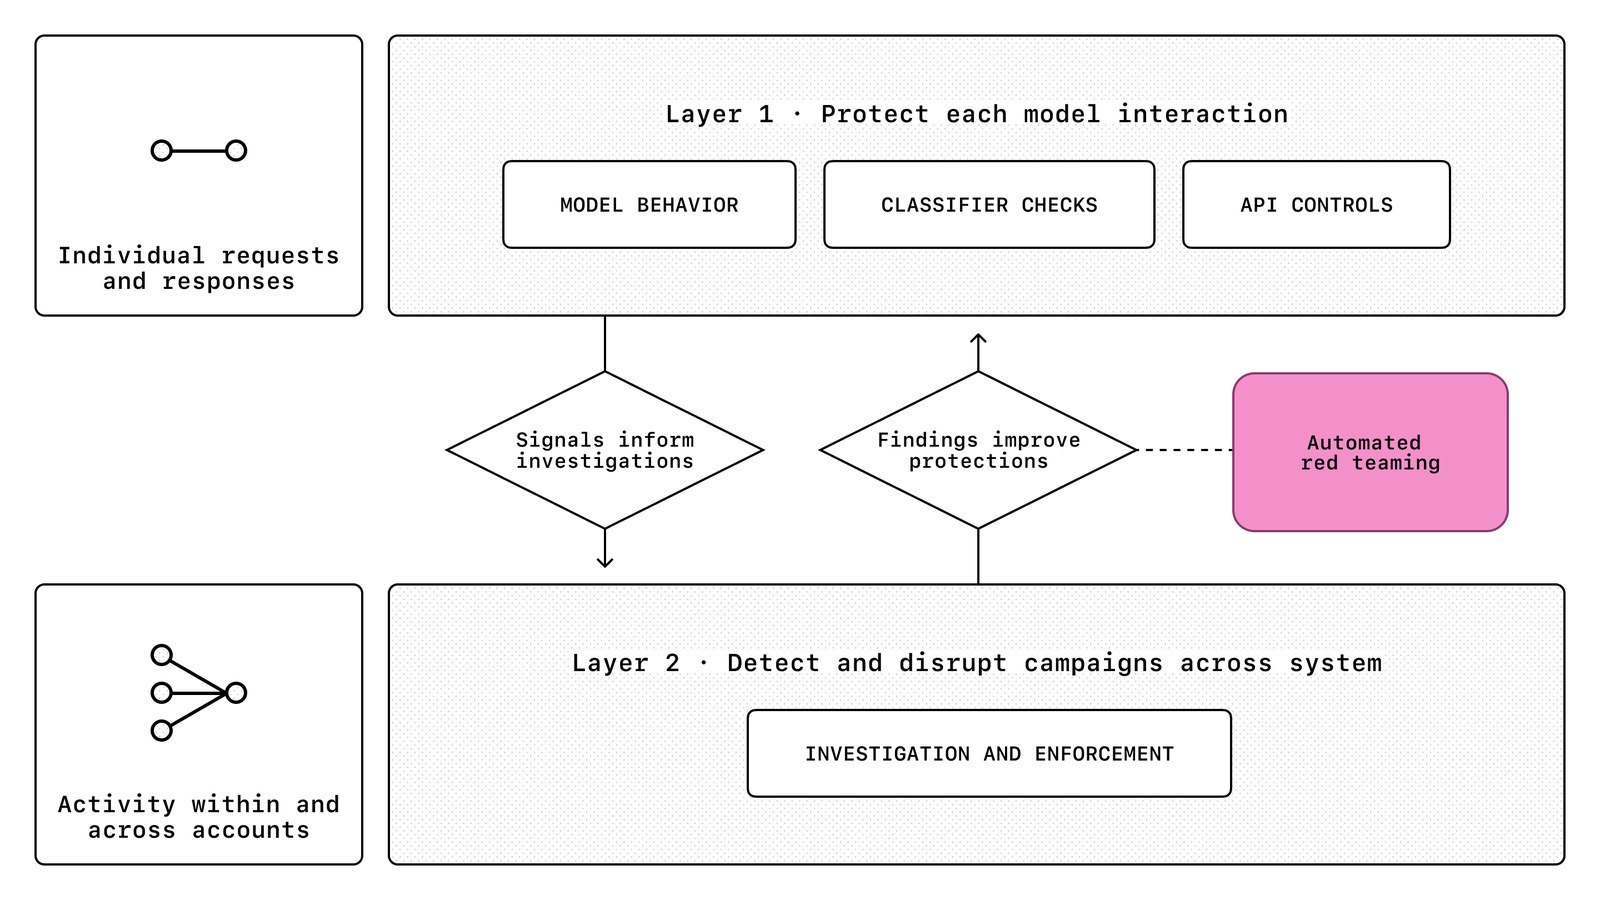
OpenAI 的做法不是单点加固,而是多层叠加:对抗性测试、模型训练、分类器、API 层保护,再加上对协同提取行为的调查与处置。这套组合更接近它在生物和网络安全领域使用的防护级别。
效果用一组内部自适应评测来衡量:让强自动化红队尝试从模型回答中恢复此前的受保护推理。对使用原始防护的 GPT-6 Astra,平均攻击成功率达到 54.0%;换到更新防护的 GPT-6.2 Astra,降到了 0.2%。这是一个超过两个数量级的下降,但它有一个重要前提——这是内部评测,攻击方策略、模型版本和评测方法都由 OpenAI 自己设定。
文章还提到“测量进展”的几个维度:对推理提取的抵抗能力,以及对协同攻击活动的检测与执法。前者是技术问题,后者更接近情报和运营:蒸馏往往不是一次调用,而是成规模的账号、提示词和流量模式,识别这些模式需要和 API 滥用治理打通。
国家安全,被摆上了台面
值得注意的是,OpenAI 专门用一节谈“对抗性蒸馏的国家安全影响”。这不是危言耸听。前沿模型能力已经被视为战略资产,未经授权的能力转移,等于把出口管制想拦住的东西,从 API 这个口子放了出去。
这也解释了为什么 OpenAI 选择公开这套方法。单靠一家公司防守,成本高、覆盖窄;如果整个行业都采用相似的检测与保护标准,攻击者的迁移成本才会上升。文章最后也呼吁其他机构在这项工作上继续搭建。
趋势:模型安全,从“对齐”走向“防泄漏”
过去谈 AI 安全,焦点多在模型会不会胡说、会不会作恶。对抗性蒸馏提醒我们,还有一类风险来自“能力被搬走”:原模型守住了底线,复制品却没有。随着开源模型能力提升、API 价格下降,这条灰色产业链只会更活跃。
0.2% 是一个漂亮的数字,但它不是终局。攻击手段会进化,评测也会过时。真正值得关注的,是行业能不能形成一套共享的检测标准——就像网络安全里的威胁情报交换。否则,每家公司都在自己的围墙里加固,攻击者只需要找最矮的那一段。
本文地址:https://www.163264.com/22269