英伟达不想再堆显存了:HBM 只加 3%,每美元智能体吞吐量最高翻 30 倍
一家公司把客服流程交给智能体之后,工程师发现账单的涨法很奇怪:GPU 数量没翻倍,Token 也…

文章目录
一家公司把客服流程交给智能体之后,工程师发现账单的涨法很奇怪:GPU 数量没翻倍,Token 也没暴增,但推理成本每周都在往上跳。往下查,问题不在算力,而在显存——智能体每次调用工具都要把历史上下文重新带一遍,KV 缓存越堆越厚,HBM 很快被塞满。卡不是算不动,是放不下。
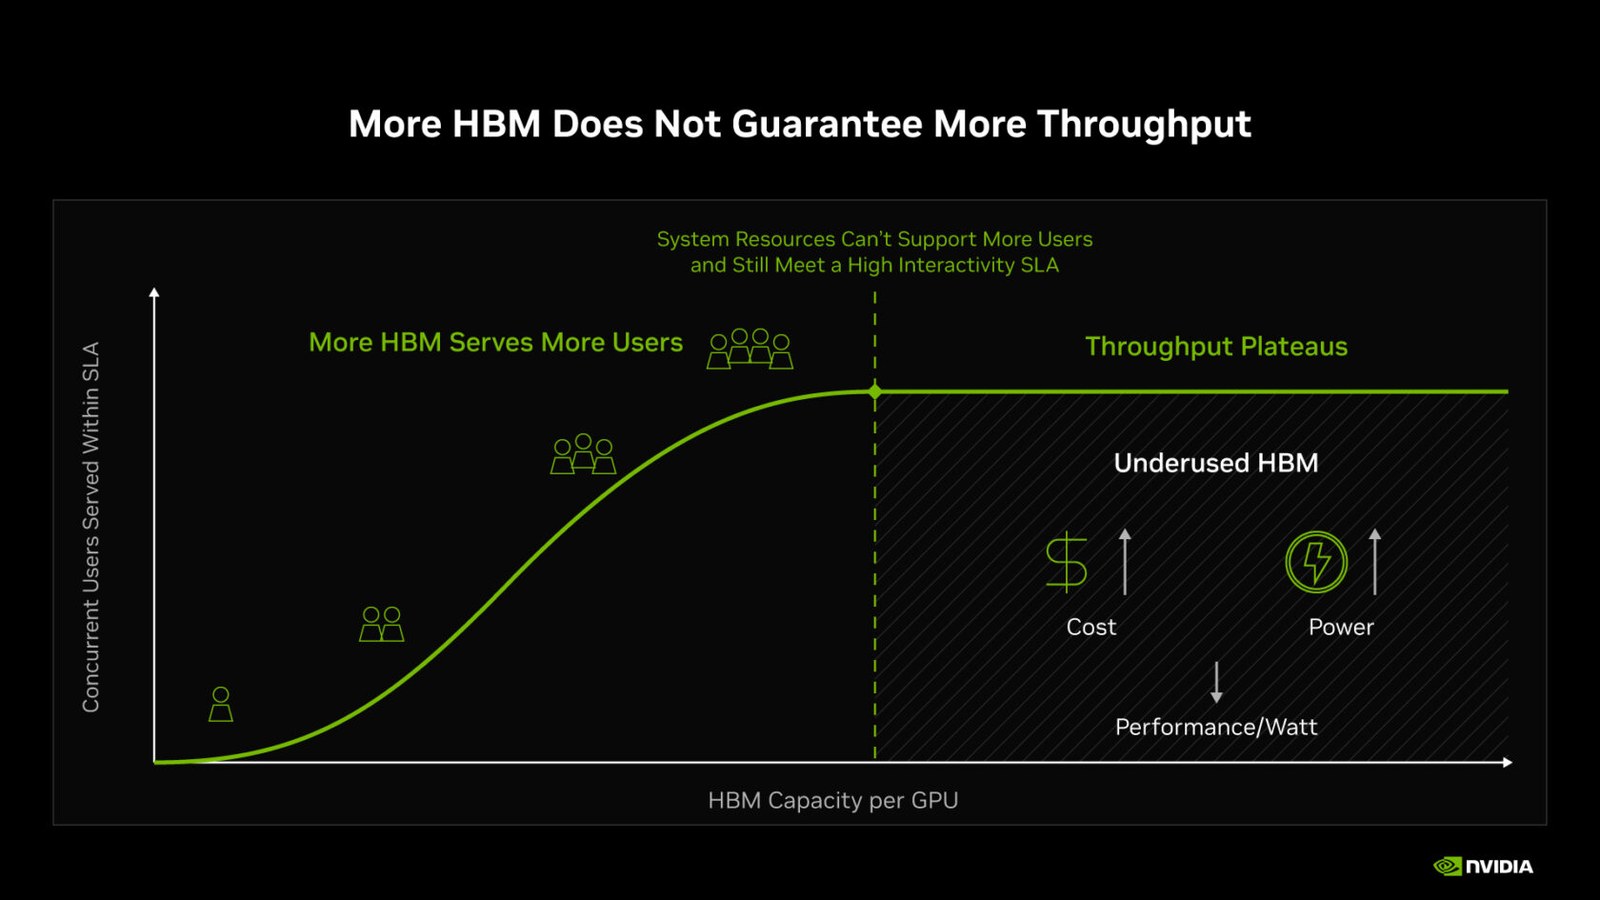
这也是英伟达 11 月 5 日那份技术解读想回答的问题。它的结论有点反直觉:接下来 AI 数据中心的竞争力,不再取决于谁把显存堆得更大。
一分钟速览
- 英伟达发布技术解读,提出用“全栈协同设计”破解 AI 内存瓶颈。
- Vera Rubin NVL72 对比 GB300 NVL72,每美元智能体吞吐量最高提升 30 倍,而每 GPU 的 HBM 容量只增加约 3%。
- 关键手段包括 NVFP4 低精度压缩、把模型权重分散到最多 72 颗 GPU、用 Vera CPU 的大容量 LPDDR 做就近缓冲,以及 Dynamo 把不活跃上下文搬到 CMX 存储。
- Vera CPU 实测:同等 100 兆瓦电力下,每瓦可支持的智能体数量是最快 x86 CPU 的 1.6 倍。
- 竞争记分牌正在从“显存多大”换成“每字节、每瓦特能产出多少有效 token”。
内存墙:最贵的那层,不该装所有东西
英伟达在文中把 HBM 比作仓库,把内存带宽比作装卸口。仓库再大,如果进出速度跟不上,新增容量也变不成服务能力,这就是“内存墙”。
麻烦在于智能体的用法。传统对话一次问答只带一段上下文,智能体却要在多次模型调用和工具调用之间反复携带历史,部分场景单次任务要处理多达 300 万个 token;再叠加 RAG 把企业资料塞进提示词,HBM 的压力成倍上升。
英伟达给出的思路不是“造更大的仓库”,而是分层:能压缩的压缩,能挪走的挪走,需要时再提前送回 GPU。
四层拆解:把上下文放到它该在的地方
第一层是压缩。NVFP4 低精度格式同时压缩模型权重和 KV 缓存,在精度可接受的范围内直接减少占用。
第二层是分摊。在 NVL72 系统里,模型权重可以分散到最多 72 颗 GPU,单卡不必独自扛下整个模型。
第三层是就近缓冲。Vera CPU 的大容量 LPDDR 内存为“暂停中”的上下文提供落脚点,不活跃的会话先放在 CPU 侧,避免长期霸占 HBM。
第四层是调度。Dynamo 推理软件把不活跃上下文迁移到 CMX 上下文存储,等复用时再取回;RAG 索引也可以留在 CPU 与存储侧。
这套组合的本质,是把“内存”从单一硬件指标,变成一条跨 GPU、CPU、网络和存储的流水线。哪一层放什么、什么时候搬,由软件统一决定。
数字背后:3% 的显存,30 倍的吞吐
英伟达援引 SemiAnalysis 的 AgentX 基准:在每用户每秒 125 token 的条件下,Vera Rubin NVL72 相比 GB300 NVL72,每美元智能体吞吐量最高提升 30 倍,而每 GPU 的 HBM 容量只增加约 3%。更早一代的对比里,GB300 NVL72 相对 H200 平台在每用户每秒 100 token 条件下,每美元吞吐量最高提升 10 倍。
同一批发布里,Vera CPU 的实测数据也指向同一个方向。英伟达以 100 兆瓦数据中心为场景对比:Vera 每瓦可支持的智能体数量是最快 x86 CPU 的 1.6 倍;对比能效最高的 x86 CPU,智能体速度提升 2 倍且保持能效领先。
合作方的数据更具体:Perplexity 称智能体编码任务快 1.5 倍,DeepInfra 称编排任务快至多 2.2 倍,ClickHouse 称标准软件无需专门优化即可在 176 核上接近线性扩展,Daytona 用 Vera 在 10.8 秒内启动 1000 个智能体沙箱,而 x86 平台需要 88.4 秒。
这些数字放在一起,说明瓶颈的位置变了。智能体把大量时间花在搜索、查库、写代码、跑测试上,这些环节吃 CPU;CPU 和 GPU 之间来回切换的次数,直接决定整套系统一秒钟能服务多少个 agent。
这意味着什么
对云厂商来说,采购逻辑会变。过去比的是“一张卡多少 GB”,以后要看“一兆瓦能跑多少个并发智能体、每个任务摊多少美元”。对模型公司来说,上下文管理不再只是工程细节,而是成本结构的一部分——谁能把不活跃上下文更早地挪出 HBM,谁的单任务成本就更低。
对普通用户,这种变化不会立刻可见,但会体现在价格上:智能体订阅能不能从“按次收费”走向“包月随便用”,取决于单任务成本能否再降一个数量级。英伟达这份解读给出的答案是,靠堆显存做不到,得靠整条内存流水线一起省。
本文地址:https://www.163264.com/19458