DeepSeek 下午断了 45 分钟:网页和 API 同时报“服务器暂时不可用”,现已恢复
今天下午三点多,不少开发者和普通用户同时发现,DeepSeek 的对话框弹出了同一句话:服务器暂…

文章目录
今天下午三点多,不少开发者和普通用户同时发现,DeepSeek 的对话框弹出了同一句话:服务器暂时不可用。对一家把 API 卖给大量中小团队的公司来说,45 分钟不算长,但足够让一批线上业务抖一下。
一分钟速览
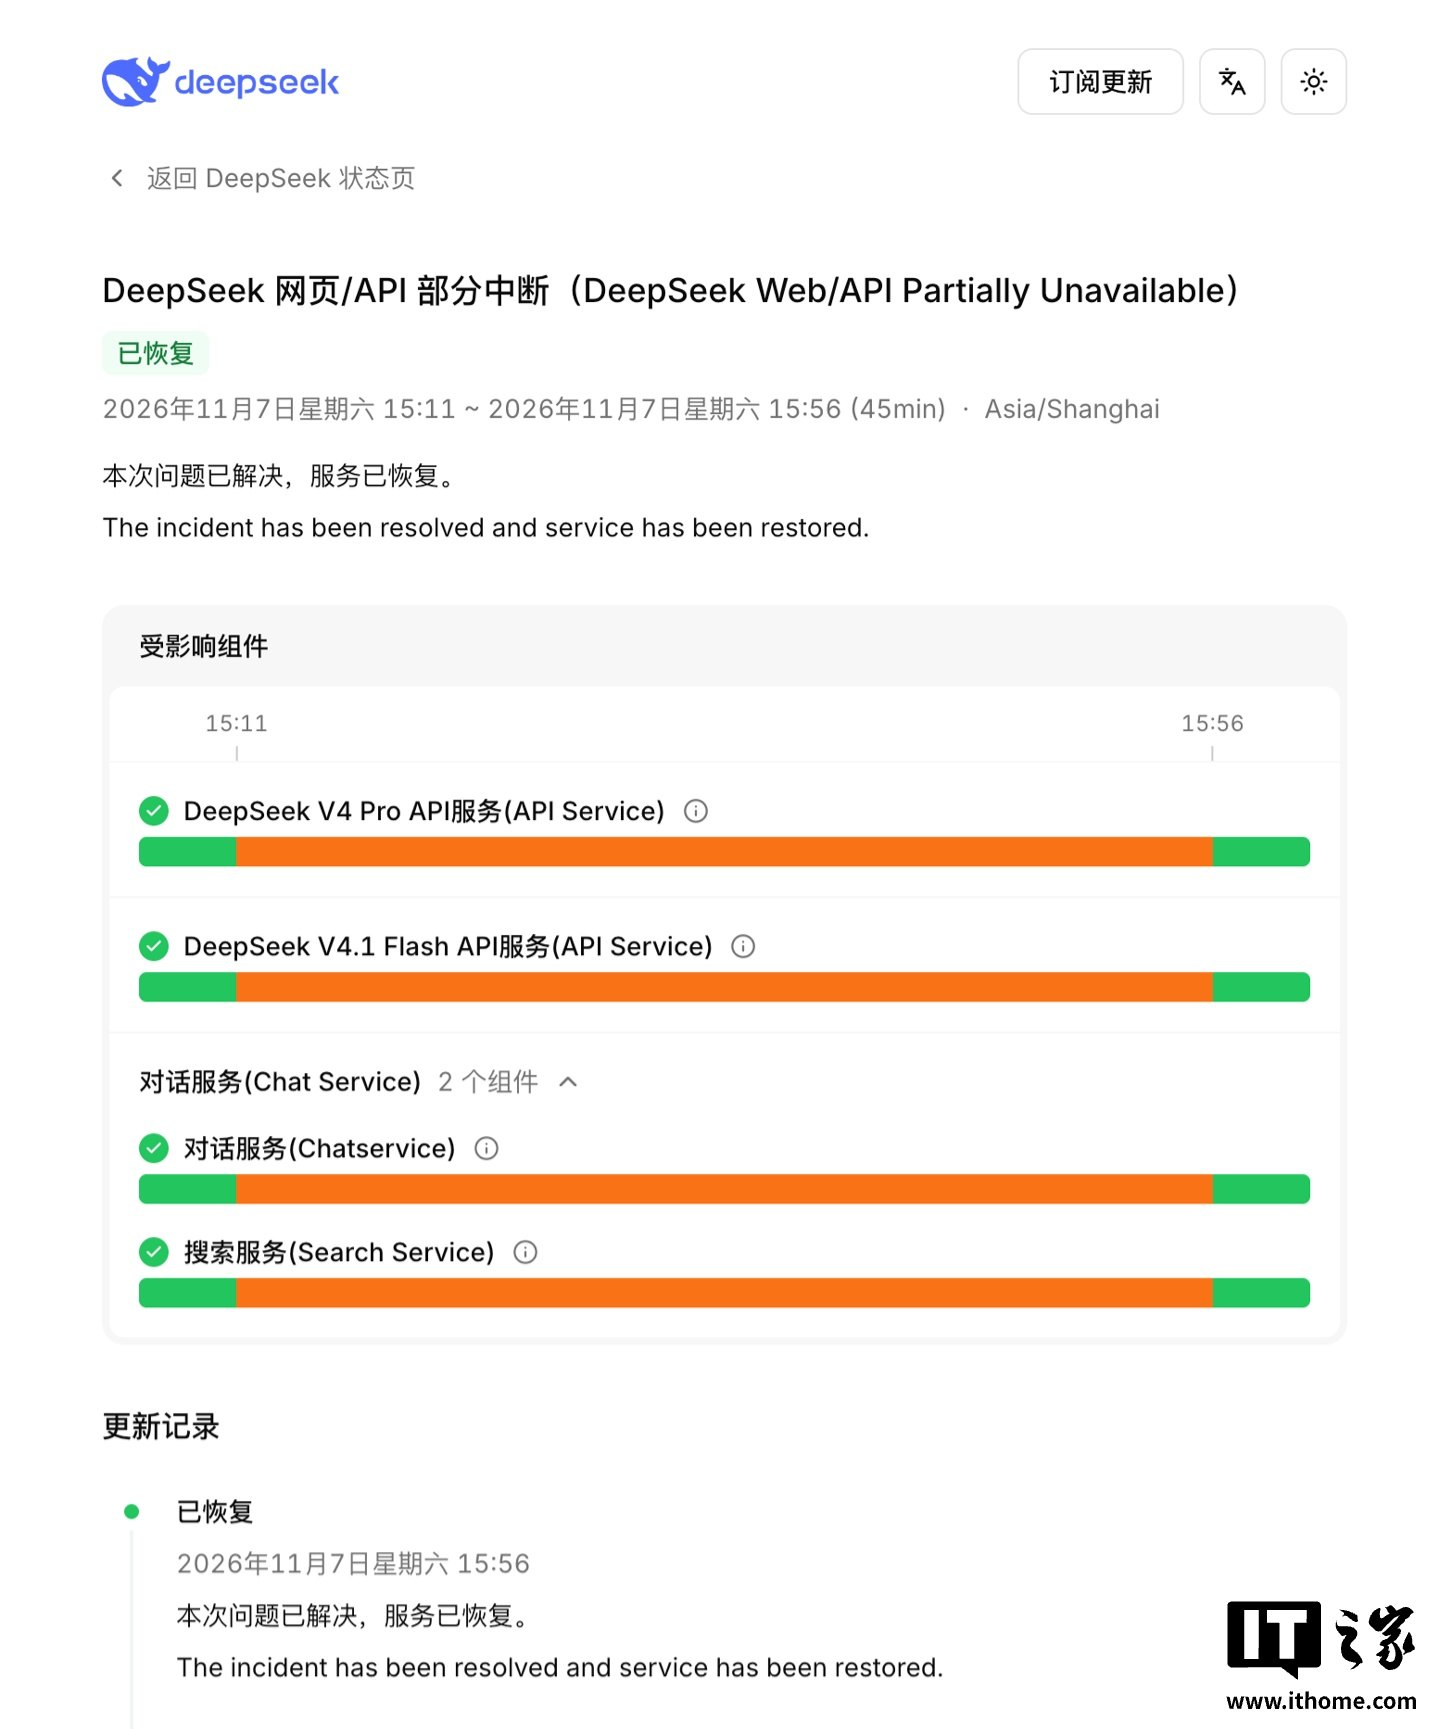
- 中断时间:11 月 7 日 15:11 至 15:56,共 45 分钟
- 影响范围:网页端与 API 部分中断,对话提示“服务器暂时不可用”
- 官方状态页已确认问题解决,服务恢复
- 多名用户在社交平台反馈,属于有感知的故障而非静默降级
- 同期没有公布具体故障原因
发生了什么
今天下午,多名用户反馈 DeepSeek 突发服务问题,网页端对话直接提示“服务器暂时不可用”。随后 DeepSeek 官方状态页更新,确认本次问题已解决、服务已恢复。从状态页记录看,网页与 API 的部分中断持续时间为 15:11 到 15:56,合计 45 分钟。
45 分钟对谁影响最大
对普通聊天用户,这就是刷新几次、换个时间再问的事。真正难受的是把 DeepSeek API 接进生产流程的团队——客服机器人、内容生成流水线、代码补全插件,这些场景没有“等一会儿再说”的选项。一旦上游返回不可用,下游要么降级到备用模型,要么直接把错误抛给终端用户。
这也解释了一个现象:越来越多团队开始做多模型路由。不是不信任某一家,而是把“单一供应商可用性”当成一个必须工程化处理的风险项。切换成本高低,往往取决于前期有没有把接口抽象干净。
为什么大模型服务仍会抖
推理服务和传统网站不太一样。它的资源消耗随请求长度剧烈波动,长上下文请求会长时间占住显存;流量又存在明显的波峰——工作日午后、新产品发布后、限时优惠期间,请求量可能瞬间翻倍。再加上模型版本更新、权重加载、扩容调度这些动作本身就可能引发短暂不可用,工程团队要在“稳定”和“快速迭代”之间反复权衡。
对用户来说,能做的其实有限:关注官方状态页,给关键链路准备兜底方案,别把单一模型当成唯一入口。
值得记下的一点
这次官方给出的是精确到分钟的故障窗口,而不是一句“已修复”。对做 SLA 的团队来说,这个信息有实际价值——可以用来核算影响面、补偿用户、复盘自己的降级策略是否生效。
参考来源:DeepSeek 官方状态页、IT之家报道。
本文地址:https://www.163264.com/19726