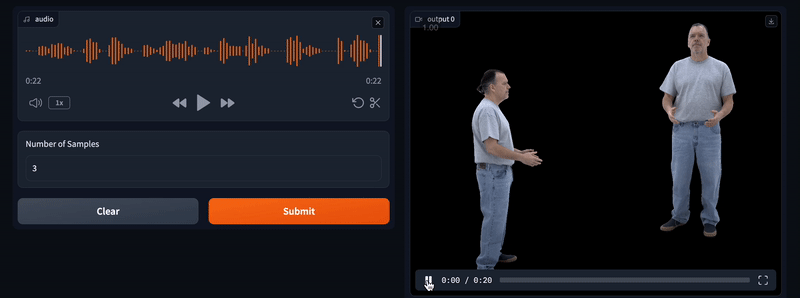
Meta发布了audio2photoreal 演示,可以从对话音频中生成逼真的面部、身体和手势
项目地址: https://people.eecs.berkeley.edu/~evonne_ng/projects/audio2photore…

栏目
大语言模型(LLM)是指使用大量文本数据训练的深度学习模型,可以生成自然语言文本或理解语言文本的含义。大语言模型可以处理多种自然语言任务,如文本分类、问答、对话等,是通向人工智能的一条重要途径
项目地址: https://people.eecs.berkeley.edu/~evonne_ng/projects/audio2photore…
代码库:https://github.com/florestefano1975/comfyui-portrait-master/ 提供了与 Po…
DreamTalk是一个基于扩散模型的框架,由清华大学、阿里巴巴和华中科大共同开发。它能够根据音频让人物头像照片说话、唱歌并保持嘴唇的同步和模仿…
只需要一张人物照片和服装照片就可以让那个人穿上这个衣服,特色是可以为不同的姿势和身体形状创建高质量的虚拟试穿。(目前还没有代码) 体验地址: h…
该模型能够通过聆听和理解给定的音乐上下文来生成新的音乐。它能够分析音乐的特点,如旋律、节奏和风格。 StemGen是一个音乐生成模型,它可以根据…
DreaMoving是一个基于扩散的可控视频生成框架,用于生成高质量的定制人类视频。它可以根据给定的目标身份和姿势序列,在任何地方生成目标身份跳…
AI 能将视频中的主题转化为 SVG 素描!因此,素描视频合成可以实现各种渲染技术,包括调整大小、填充颜色以及在原始背景图像上叠加涂鸦。 项目地…
Meta推出了一款名为Audiobox的音频生成模型,它可以通过语音输入和自然语言文本提示来生成语音和音效,用于创建自定义音频。据Meta称,A…
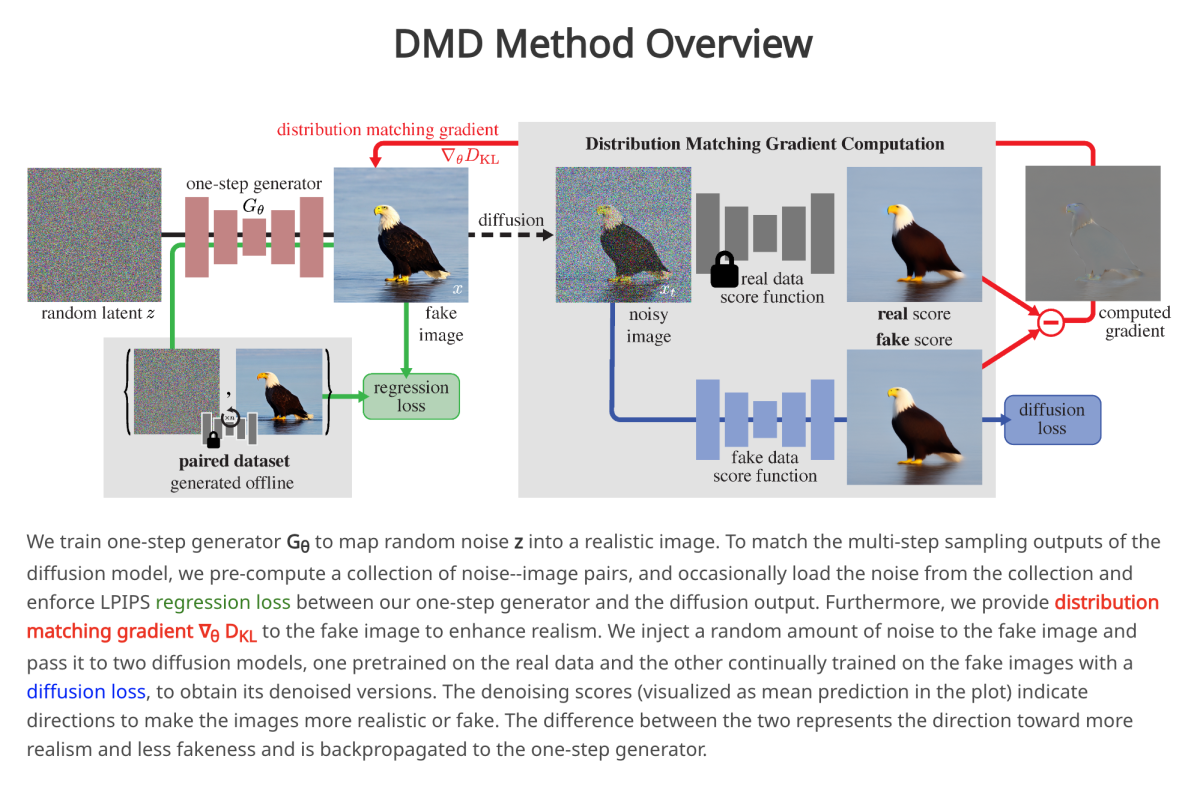
Adobe和麻省理工学院的研究人员共同发布论文,介绍一种分布匹配蒸馏(Distribution Matching Distillation,DM…
来自阿里的研究团队发布论文,利用扩散模型的能力,提出了一个专门针对角色动画的新框架Animate Anyone,可从静态图像AI生成动态视频,从…