MMAudio:输入视频或文本可自动给视频配音效
MMAudio是一项由伊利诺伊大学厄巴纳-香槟分校、Sony AI及Sony集团联合推出的新技术,它能够实现视频到音频的高质量合成。这项技术的核…

栏目
关于AI相关开源项目,附带项目代码地址
MMAudio是一项由伊利诺伊大学厄巴纳-香槟分校、Sony AI及Sony集团联合推出的新技术,它能够实现视频到音频的高质量合成。这项技术的核…
家人们,好消息!Exo Labs带着他们的黑科技来了,现在你的Mac M4电脑也能变身强大的本地AI模型运行器啦!🌌 🍎【Apple M4芯片的…
亲爱的时尚达人们,想要快速预览穿上心仪衣物的效果吗?Fashion-VDM来帮你实现这个愿望!只需一张图+视频,就能展示穿上输入衣物后的神奇效果…
利用多视角扩散模型和遮罩视频微调技术,实现粗略视频到清晰、连贯、动感视频的转变。适用于各种视频和视角转换,让普通用户也能制作专业级“多机位”视频…
FLUX.1-dev LoRA 是由 TryOn Labs 开发的一款服装生成器,它利用先进的人工智能技术,能够根据用户输入的服装描述(包括颜色…
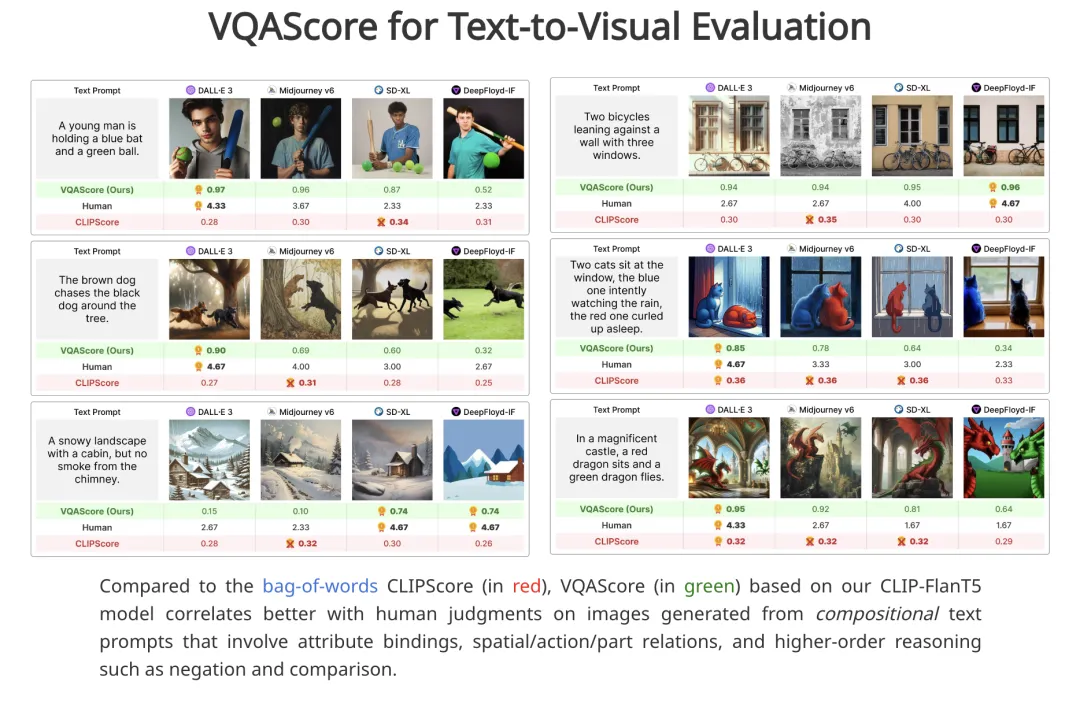
VQAScore是一种新的文本到视觉生成评估指标,通过CLIP-FlanT5模型计算图像与文本提示的匹配度,优于传统CLIPScore。它使用V…
这个GitHub仓库名为“Regional-Prompting-FLUX”,由instantX-research组织创建。它提供了一个名为“Tr…
Hertz-Dev 是一个开源音频模型,它具有 8.5 亿参数。该模型在延迟方面表现出色,理论延迟仅有 80 毫秒,实际延迟为 120 毫秒。这…
研究人员设计出一种简单有效的流程,这个流程能够唤醒 Diffusion 模型的 “上下文学习” 能力。这样做的好处是大大降低了 AI 模型的训练…